[LLM Serving] LLM 토큰 스트리밍에 SSE를 선택한 이유: 프로토콜 비교부터 HTTP/3까지
들어가며
많은 사람들이 요새는 AI 도구를 많이 사용해 봐서 알겠지만 AI 채팅에 대한 요청은 한번에 모든 응답값을 받지 않는다.
마치 채팅 하는것 처럼 느껴지게 하나씩 응답이 오는데 이전 글에서 테스트 했던 내용도 마찬가지였다.
1
2
3
curl http://localhost:8000/v1/chat/completions \
  -H "Accept: text/event-stream" \
  -d '{"model": "Qwen2.5-7B", "messages": [{"role": "user", "content": "장애 로그를 분석해줘"}], "stream": true}'
LLM은 토큰을 하나씩 생성(Autoregressive)하기 때문에, 첫 토큰이 나오는 순간부터 클라이언트에게 스트리밍해야 자연스럽다. 만약 200토큰을 모두 생성한 뒤 한 번에 보내면, 사용자는 5~13초간 빈 화면을 보게 되고 사용자의 이탈로 이어지게 될것이다.
이전 글에서는 vLLM의 Continuous Batching이 throughput을 6배 향상시키는 것을 확인했다. 하지만 생성된 토큰을 클라이언트에게 어떤 프로토콜로 전달할 것인가는 별개의 문제다.
이 글에서는 LLM 스트리밍 서버를 구축할 때 왜 SSE(Server-Sent Events)를 선택했는지, 프로토콜 수준의 네트워크 통신 비교, 실제 LLM 서비스(ChatGPT·Claude)의 구현 분석, 그리고 Last-Event-ID를 활용한 메시지 유실 방지 전략까지 알아 보도록 하자
목차
- 실시간 통신 프로토콜 비교: HTTP Polling vs SSE vs WebSocket
- HTTP 버전별 SSE 영향: 1.1 → 2.0 → 3.0 (QUIC)
- 실제 LLM 서비스 분석: ChatGPT vs Claude
- Last-Event-ID Deep Dive: 메시지 유실 방지 전략
- SSE 서버는 언제 힘이 들까? — 성능 모델링
- 마무리: 왜 SSE인가
1. 실시간 통신 프로토콜 비교
LLM 스트리밍을 위한 프로토콜 후보는 크게 세 가지다. 각각의 네트워크 통신 흐름을 프로토콜 수준에서 비교해보자.
1.1 HTTP Polling
아키텍쳐 환경 : HTTP/1.1, Keep-Alive : active, Polling 방식
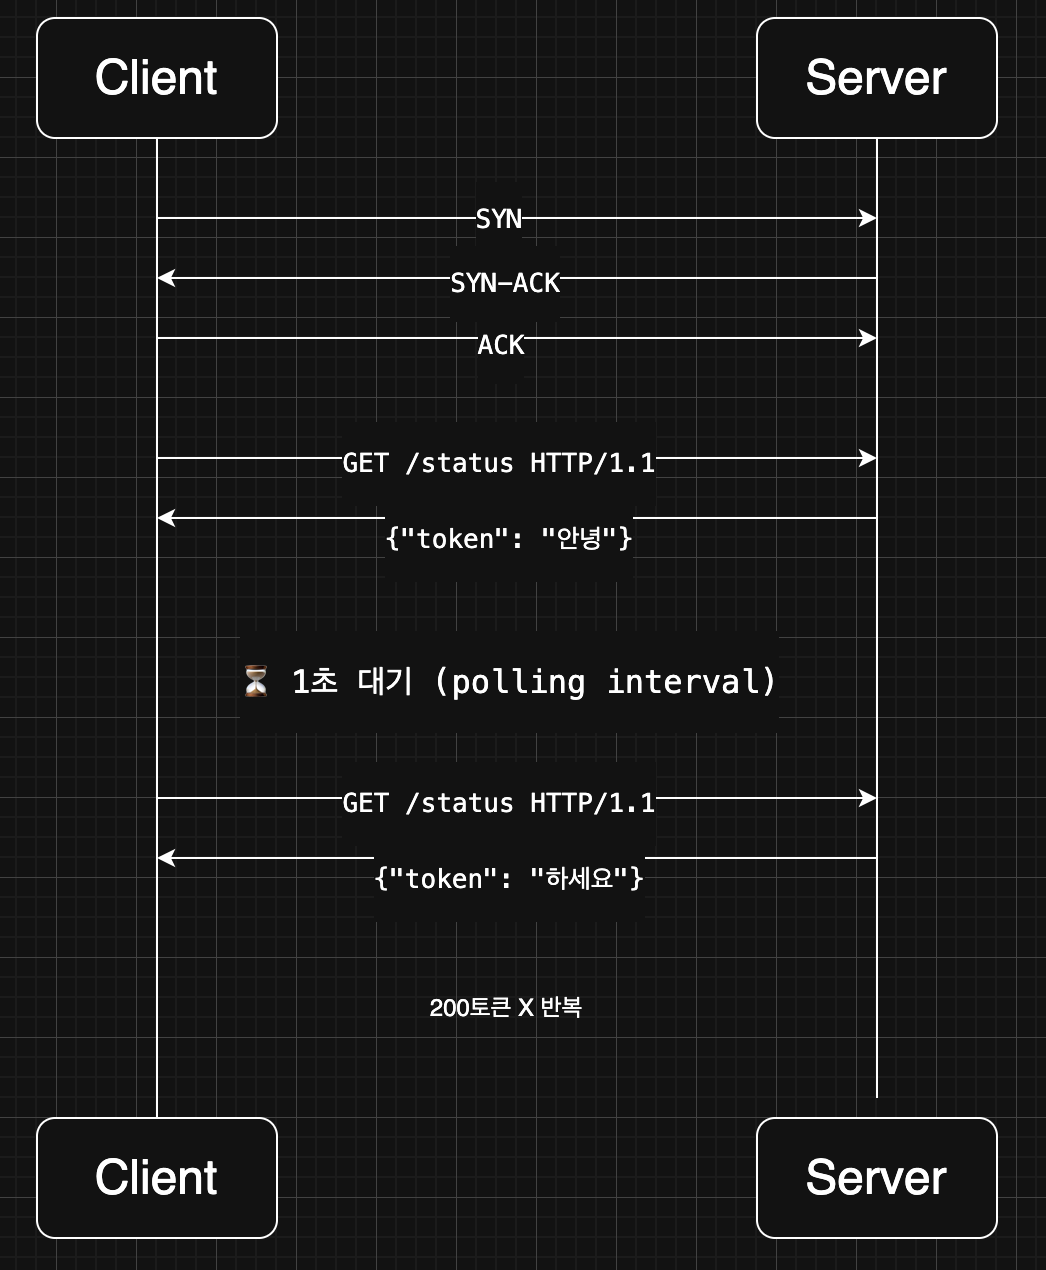 ▲ HTTP Polling: 매 요청마다 TCP Handshake가 반복되고, 업데이트가 없어도 응답 사이클이 발생한다
매 요청마다 TCP 3-way Handshake(SYN → SYN-ACK → ACK)가 발생하고, TLS를 사용한다면 TLS Handshake까지 추가된다. 업데이트가 없어도 요청-응답 사이클이 반복되므로 서버 리소스와 네트워크 대역폭이 낭비된다. 200토큰을 수신하려면 수십 회의 HTTP 요청과 응답에 대한 반복이 필요하다.
1.2 Server-Sent Events (SSE)
아키텍쳐 환경 : HTTP/1.1, Keep-Alive : active, Server-Sent Events 방식
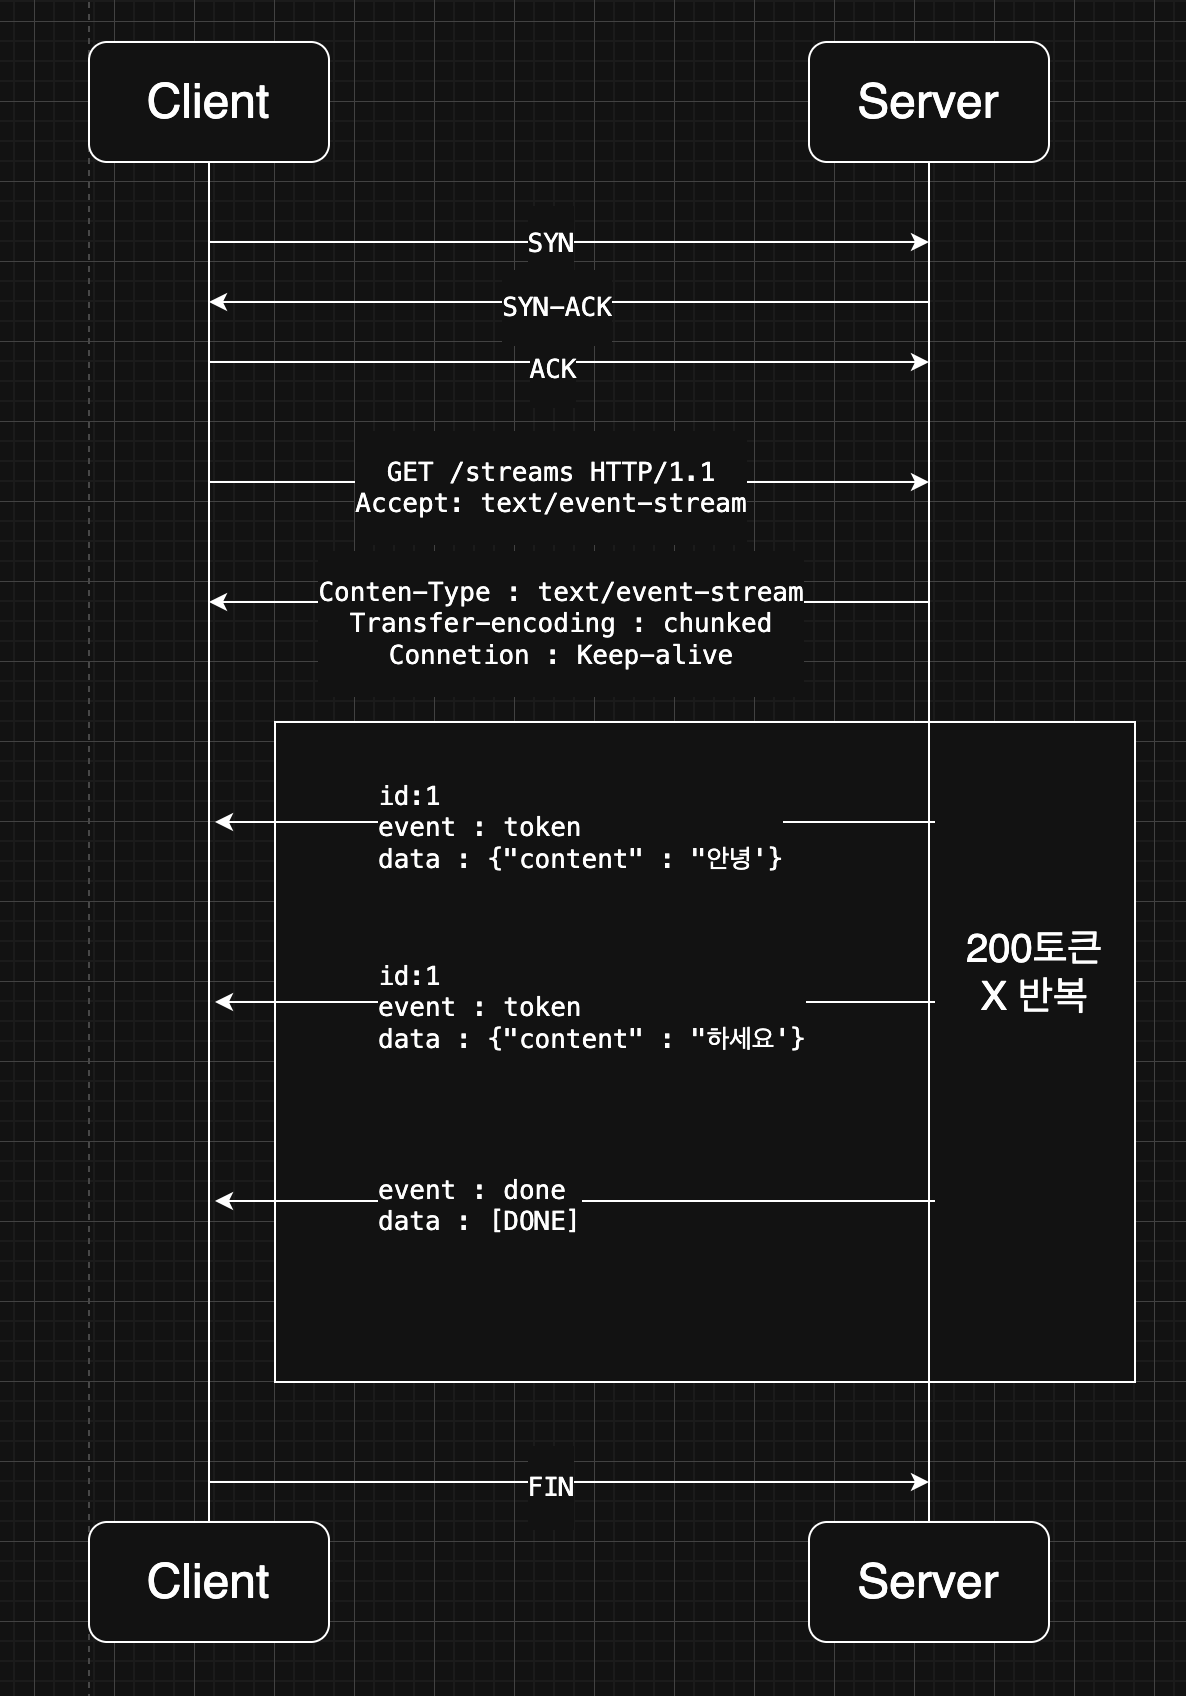 ▲ SSE: 최초 1회 TCP Handshake 후 연결을 유지하며 서버가 이벤트를 단방향으로 push
TCP Handshake는 최초 1회만 발생한다. 이후 서버는 응답을 완료하지 않고, Chunked Transfer Encoding으로 연결을 열어둔 채 토큰을 하나씩 push한다. event:, id:, data: 필드로 구조화된 텍스트 이벤트를 전달하며, id: 필드는 재연결 시 Last-Event-ID로 활용된다.
1.3 WebSocket
아키텍쳐 환경 : HTTP/1.1, Keep-Alive : active, Websocket 방식
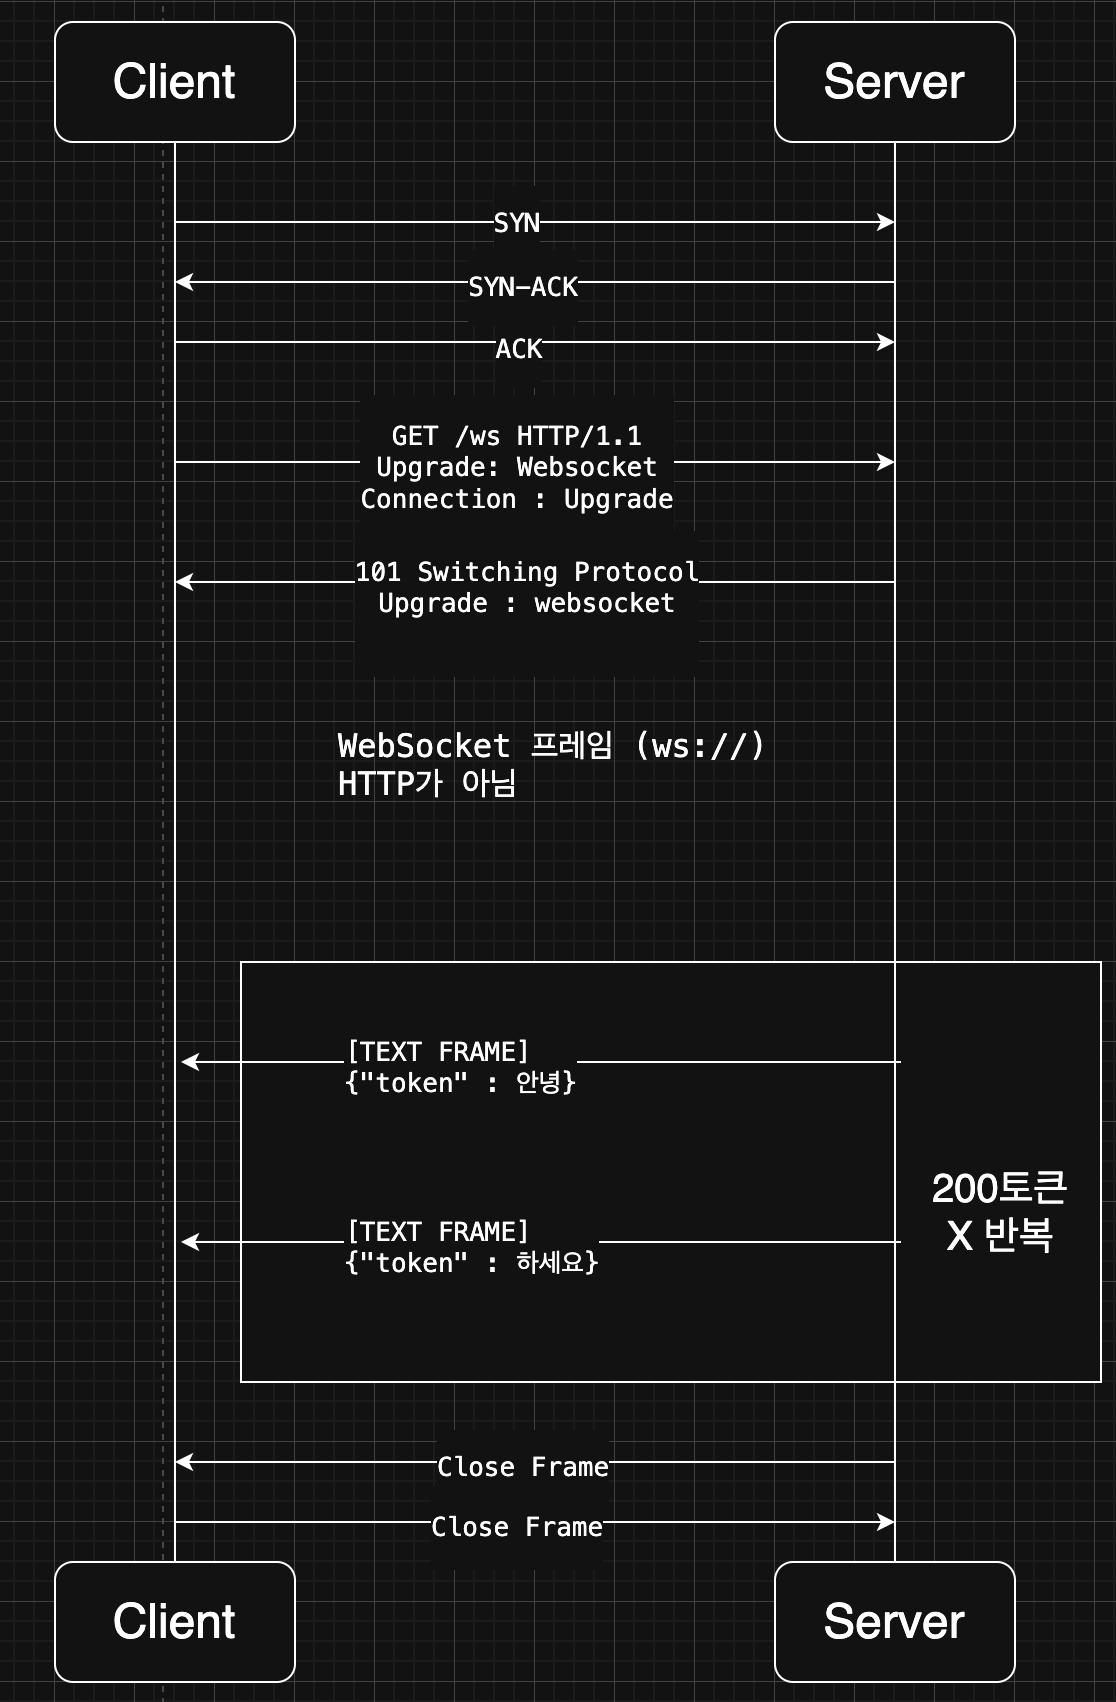 ▲ WebSocket: HTTP Handshake 후 ws:// 프로토콜로 업그레이드하여 양방향 통신
WebSocket은 초기 HTTP Handshake 이후 완전히 다른 프로토콜(ws://)로 전환된다. 양방향 통신이 가능하지만, LLM 스트리밍에서 클라이언트 → 서버 방향은 거의 불필요하다. 101 Switching Protocols 이후 HTTP 프레임이 아닌 WebSocket 프레임으로 통신하므로, HTTP/2·3의 멀티플렉싱 혜택을 받을 수 없다.
참고로 WebSocket도 이론적으로는 HTTP/2(RFC 8441, Extended CONNECT)와 HTTP/3(CONNECT 기반)에서 동작이 가능하다. 하지만 실무에서는 여전히 HTTP/1.1 기반처럼 사용된다. 대부분의 로드밸런서와 CDN이 HTTP/2 WebSocket을 제한적으로만 지원하고, 멀티플렉싱과 헤더 압축이 stateful한 WebSocket 연결에서는 실질적 의미가 없기 때문이다.
1.4 프로토콜 비교 표
| 특성 | HTTP Polling | SSE | WebSocket |
|---|---|---|---|
| 연결 방식 | 매 요청마다 새 연결 | HTTP 연결 유지 | HTTP → ws:// 업그레이드 |
| 데이터 흐름 | Client → Server | Server → Client | 양방향 |
| TCP Handshake | 매번 | 1회 | 1회 |
| 자동 재연결 | ❌ 직접 구현 | ✅ EventSource API 내장 | ❌ 직접 구현 |
| Last-Event-ID | ❌ | ✅ 표준 지원 | ❌ 직접 구현 |
| 방화벽 | ✅ 80/443 | ✅ 80/443 | ⚠️ 일부 차단 |
| 로드밸런서 | ✅ Stateless | ✅ HTTP 기반 | ⚠️ Sticky Session |
| HTTP 버전 적용 | ✅ 자동 | ✅ 자동 | ⚠️ 이론상 가능, 실무 제한적 |
| LLM 스트리밍 | 🔴 | 🟢 | 🟡 |
1.5 LLM 스트리밍에 SSE가 최적인 이유
LLM 스트리밍은 본질적으로 서버 → 클라이언트 단방향 통신이다.
1
2
3
4
5
6
LLM 스트리밍의 통신 패턴:
  1. Client → Server: REST API로 프롬프트 전송 (POST)
  2. Server → Client: SSE로 토큰 스트리밍 (text/event-stream)
  3. Client → Server: 필요 시 REST API로 중단 요청 (POST)

→ WebSocket의 양방향은 불필요. REST API + SSE 조합이 최적.
실제로 OpenAI, Anthropic, Google(Gemini) 모두 LLM 응답 스트리밍에 SSE를 사용한다. SSE의 HTTP 기반 단순성, 자동 재연결, Last-Event-ID가 LLM 스트리밍의 요구사항과 정확히 맞아떨어지기 때문이다.
2. HTTP 버전별 SSE 영향
SSE는 HTTP 위에서 동작하므로, HTTP 버전이 올라갈수록 SSE도 그 혜택을 자동으로 받는다.
2.1 HTTP/1.1 — 연결 수 제한
1
2
3
4
5
6
7
8
9
10
11
[HTTP/1.1 + SSE]

Browser ─── TCP #1 ──→ SSE Stream A
        ─── TCP #2 ──→ SSE Stream B
        ─── TCP #3 ──→ API Request
        ─── TCP #4 ──→ API Request
        ─── TCP #5 ──→ Static Asset
        ─── TCP #6 ──→ Static Asset
        ─── ❌ 7번째 ──→ 블로킹!

제한: 브라우저당 도메인별 최대 6개 TCP 연결
2.2 HTTP/2 — 멀티플렉싱
1
2
3
4
5
6
7
8
9
10
[HTTP/2 + SSE]

Browser ═══ 단일 TCP ═══> Server
            ├── Stream 1: SSE Stream A
            ├── Stream 2: SSE Stream B
            ├── Stream 3: API Request
            └── Stream 100: ...

해소: 하나의 TCP에 최대 100개 논리적 스트림
⚠️ 남은 문제: TCP 패킷 유실 시 모든 스트림 대기 (TCP HOL Blocking)
2.3 HTTP/3 (QUIC) — TCP의 한계를 넘다
1
2
3
4
5
6
7
8
[HTTP/3 + SSE]

Browser ═══ QUIC (UDP) ═══> Server
            ├── Stream 1: SSE A  ← 패킷 유실 → 이 스트림만 영향
            ├── Stream 2: SSE B  ← 독립 동작
            └── Stream 3: API    ← 독립 동작

해소: 스트림 간 완전 독립 + 0-RTT 재연결 + Connection Migration
2.4 재연결 비용 비교
SSE의 자동 재연결 시 HTTP 버전에 따라 비용이 크게 달라진다.
1
2
3
4
5
재연결 시 Handshake 비용:

HTTP/1.1: TCP 3-way (1 RTT) + TLS 1.2 (2 RTT) = 3 RTT
HTTP/2:   TCP 3-way (1 RTT) + TLS 1.3 (1 RTT) = 2 RTT
HTTP/3:   QUIC 0-RTT                            = 0 RTT ← 즉시!
HTTP/3의 0-RTT는 SSE 자동 재연결과 시너지를 낸다. 모바일 환경에서 네트워크가 불안정할 때, Last-Event-ID와 함께 거의 지연 없이 스트림을 복원할 수 있다. 또한 QUIC의 Connection Migration은 Wi-Fi → 셀룰러 전환 시에도 연결이 끊기지 않는다.
2.5 HTTP 버전별 비교 표
| 특성 | HTTP/1.1 | HTTP/2 | HTTP/3 (QUIC) |
|---|---|---|---|
| SSE 동시 연결 | 도메인당 6개 | ~100개 스트림 | ~100개 스트림 |
| HOL Blocking | 🔴 연결 레벨 | 🟡 TCP 레벨 잔존 | 🟢 완전 해소 |
| 재연결 비용 | 3 RTT | 2 RTT | 0 RTT |
| 네트워크 전환 | ❌ 끊김 | ❌ 끊김 | ✅ Migration |
| 헤더 압축 | ❌ | ✅ HPACK | ✅ QPACK |
1
2
3
4
5
6
현실적 선택:
  - 현재: HTTP/2 + SSE (안정적, 충분한 성능)
  - 모바일: HTTP/3 + SSE (Connection Migration 이점)
  - 미래: HTTP/3 기본화 시 SSE 이점 극대화

  핵심: SSE는 HTTP가 발전할수록 자동으로 함께 발전한다.
3. 실제 LLM 서비스 분석: ChatGPT vs Claude
이론을 넘어서, 실제 서비스들이 SSE를 어떻게 구현하고 있는지 DevTools로 분석해보았다.
3.1 ChatGPT의 스트리밍 구현
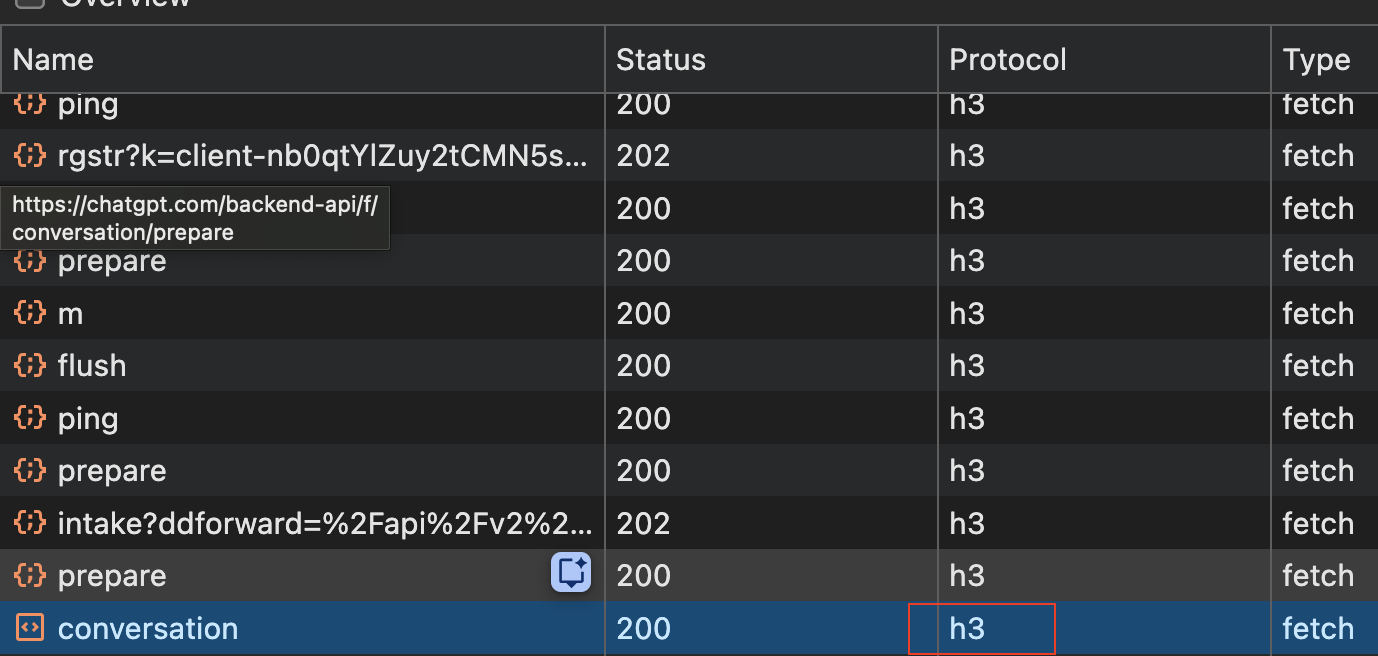 ▲ ChatGPT Network 탭: Protocol 컬럼에서 h3(HTTP/3) 사용 확인
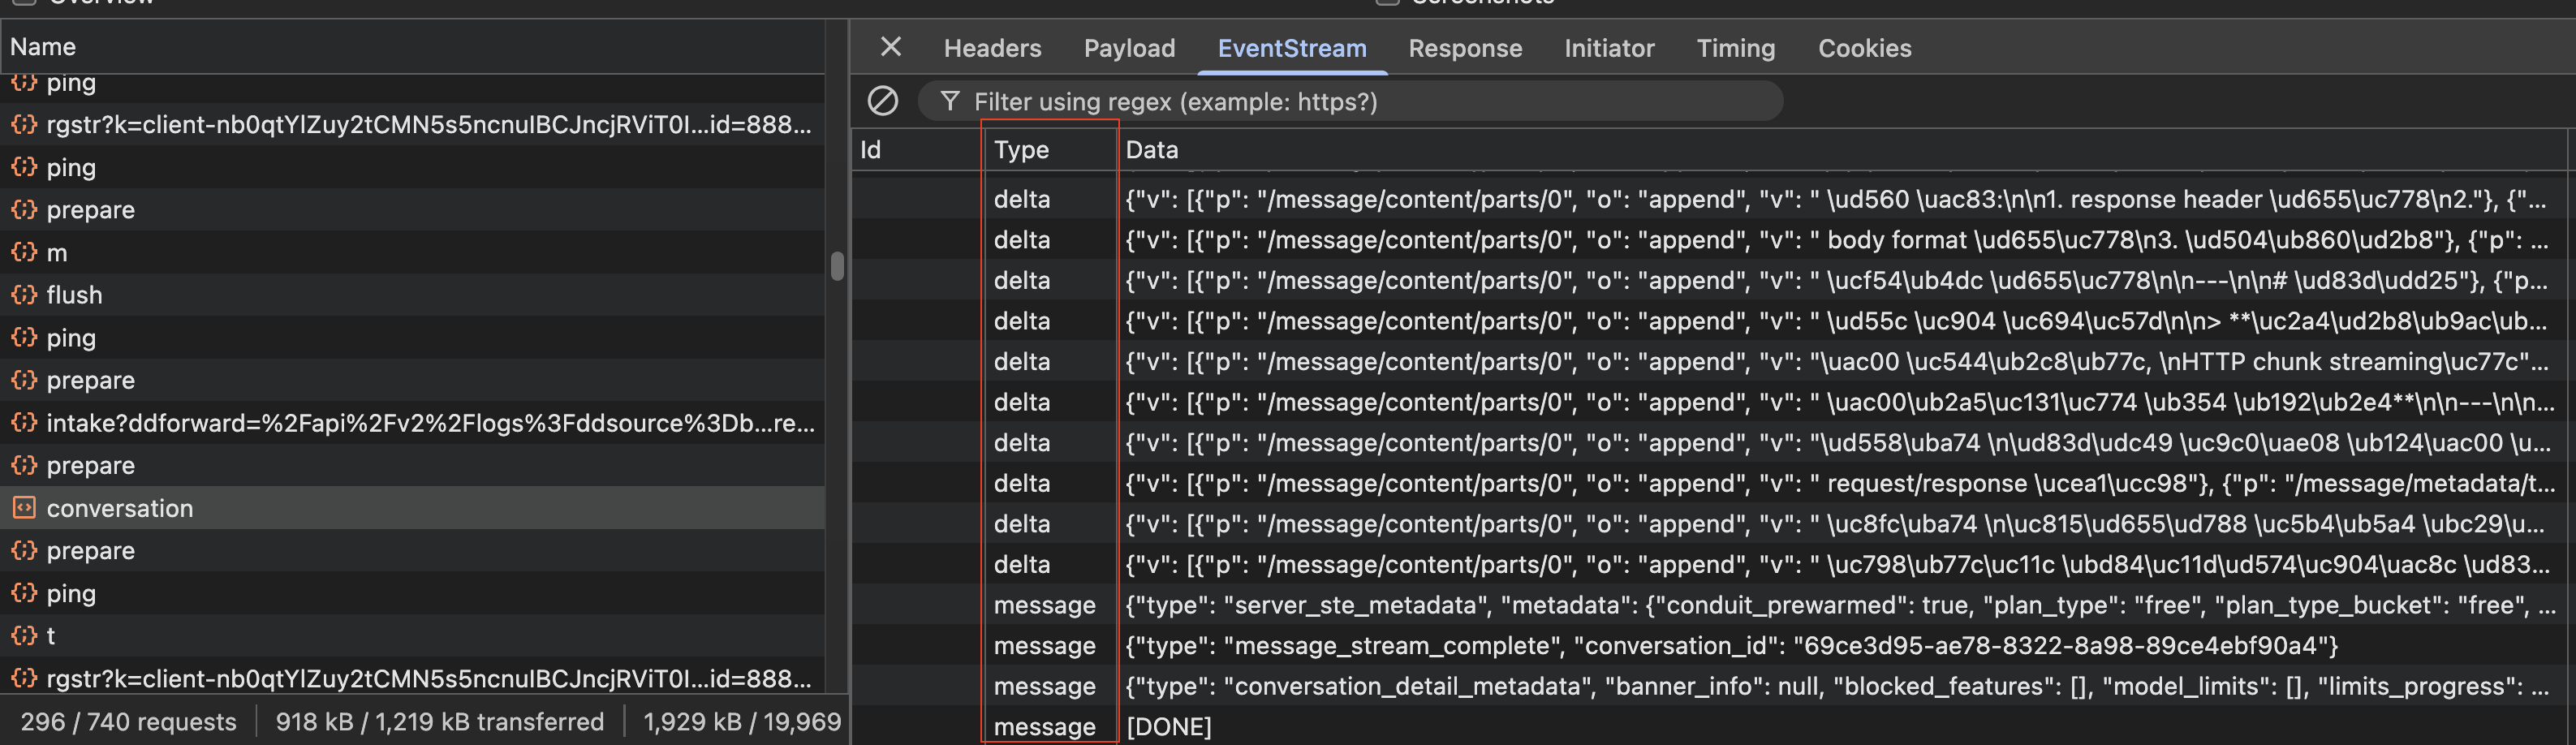 ▲ ChatGPT EventStream 탭: delta encoding 기반 이벤트 스트리밍 확인
ChatGPT의 스트리밍을 DevTools로 캡처하면 흥미로운 구조가 보인다.
HTTP 프로토콜: h3 (HTTP/3, QUIC)
ChatGPT는 HTTP/3를 사용한다. 이 덕분에 앞서 설명한 0-RTT 재연결, TCP HOL Blocking 해소, Connection Migration의 이점을 모두 누리고 있다.
메시지 포맷: SSE + Delta Encoding
ChatGPT는 표준 SSE(text/event-stream) 위에 커스텀 delta encoding을 얹은 하이브리드 방식을 사용한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
// 첫 번째 이벤트: 연결 수립 + delta encoding 선언
event: delta_encoding
data: "v1"

// 두 번째 이벤트: 전체 메시지 객체 전송 (초기 상태)
event: delta
data: {"p":"","o":"add","v":{"message":{"id":"91eb75f0-...","content":{"parts":[""]},...}}}

// 이후 이벤트: JSON Patch로 diff만 전송
event: delta
data: {"v":[{"p":"/message/content/parts/0","o":"append","v":"안녕"},
            {"p":"/message/metadata/token_count","o":"replace","v":5}]}

event: delta
data: {"v":[{"p":"/message/content/parts/0","o":"append","v":"하세요"},
            {"p":"/message/metadata/token_count","o":"replace","v":8}]}
여기서 주목할 것은 "o": "append", "o": "replace" — 이것은 JSON Patch(RFC 6902) 기반의 delta 연산이다.
3.2 Delta Encoding이 필요한 이유 — 출력 대역폭 최적화
왜 ChatGPT는 표준 SSE를 그대로 쓰지 않고 delta encoding을 도입했을까?
LLM 스트리밍에서 토큰이 누적될수록 매번 전체 메시지를 보내면 서버의 출력 데이터량이 기하급수적으로 증가한다.
1
2
3
4
5
6
7
8
9
10
[Full State 방식 — delta encoding 없이]

토큰 1: {"content": "안녕"}                          → 6 bytes
토큰 2: {"content": "안녕하세요"}                     → 15 bytes
토큰 3: {"content": "안녕하세요 장애는"}              → 24 bytes
토큰 4: {"content": "안녕하세요 장애는 OOMKilled로"}   → 39 bytes
...
토큰 200: {"content": "안녕하세요 장애는 ... (전체 응답)"} → ~2,000 bytes

총 출력: 6 + 15 + 24 + 39 + ... + 2000 ≈ O(n²) 증가!
1
2
3
4
5
6
7
8
9
10
[Delta 방식 — 변경분만 전송]

토큰 1: {"o":"append","v":"안녕"}          → 6 bytes
토큰 2: {"o":"append","v":"하세요"}        → 9 bytes
토큰 3: {"o":"append","v":" 장애는"}       → 9 bytes
토큰 4: {"o":"append","v":" OOMKilled로"}  → 15 bytes
...
토큰 200: {"o":"append","v":"합니다."}     → 12 bytes

총 출력: 6 + 9 + 9 + 15 + ... + 12 ≈ O(n) 일정!
Full State 방식에서는 토큰이 200개까지 누적되면 마지막 이벤트 하나가 전체 응답 텍스트를 반복 전송해야 한다. 동시 사용자가 1,000명이면, 이 반복 전송이 1,000배로 증폭된다. Delta 방식은 변경된 부분(새 토큰)만 전송하므로 이벤트 크기가 일정하게 유지된다.
1
2
3
4
5
6
동시 1,000명 × 200토큰 기준:

Full State: ~200MB 출력 (O(n²) × 1,000 clients)
Delta:      ~12MB 출력  (O(n) × 1,000 clients)

→ 서버 출력 대역폭 ~16배 절감
ChatGPT 규모(수백만 동시 사용자)에서 이 차이는 CDN 비용, 서버 네트워크 대역폭, 클라이언트 파싱 부하 모두에 영향을 준다. delta encoding은 단순한 최적화가 아니라, 대규모 LLM 서비스의 필수 인프라 전략이다.
또한 ChatGPT의 delta에는 토큰 텍스트뿐만 아니라 token_count, citations, search_result_groups 같은 메타데이터도 포함된다. 이런 메타데이터를 매번 전체 전송하면 낭비가 심하지만, "o":"replace" 한 줄로 변경된 필드만 갱신하면 된다.
3.3 Claude의 스트리밍 구현
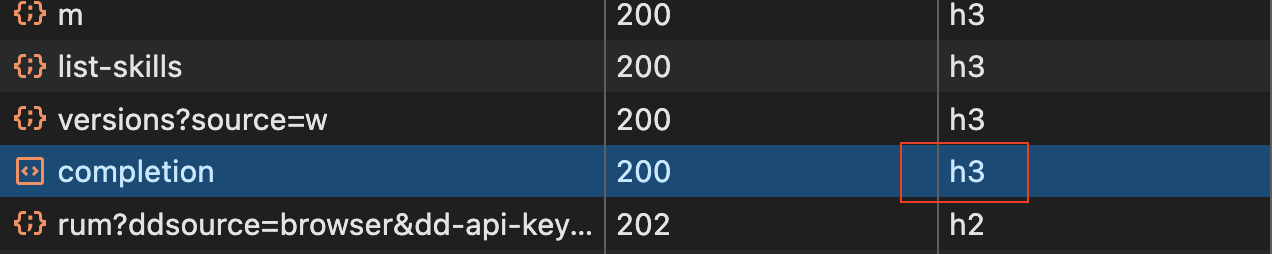 ▲ Claude Network 탭: Protocol 컬럼에서 h3 사용 확인
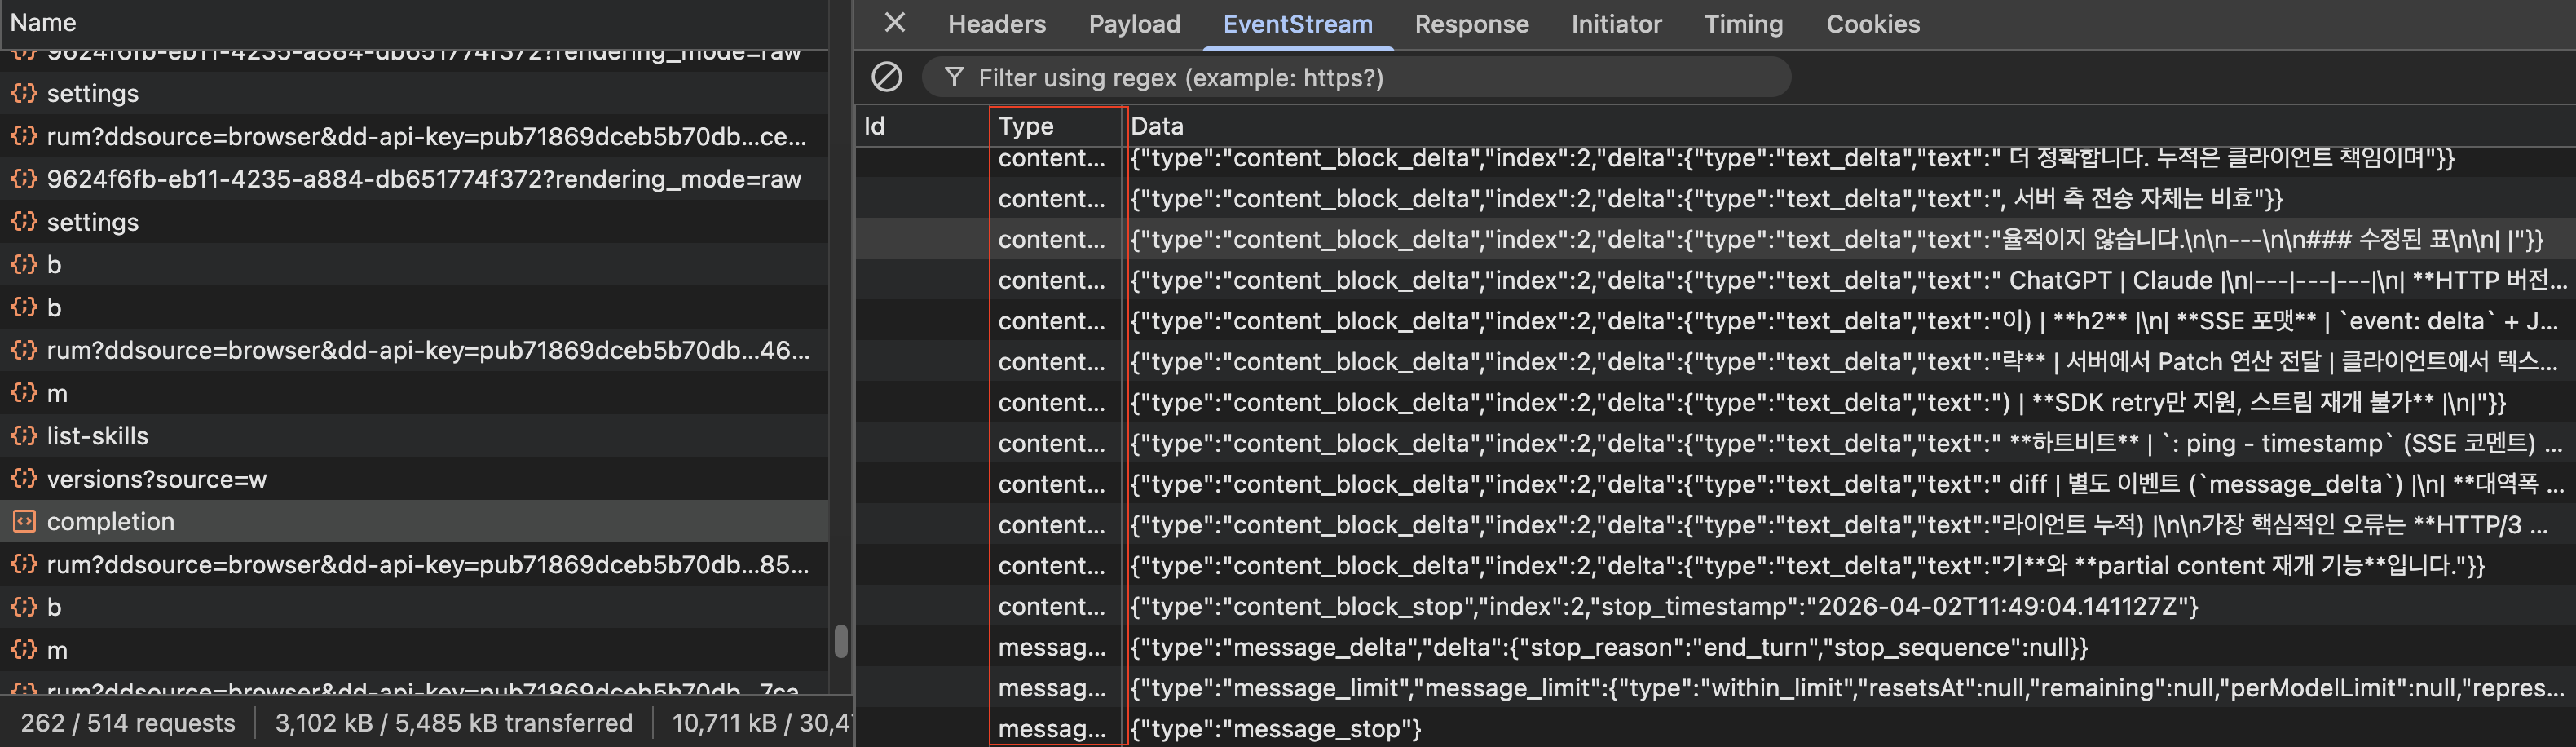 ▲ Claude EventStream 탭: content_block_delta 기반 표준 SSE 스트리밍 확인
Claude(Anthropic)는 ChatGPT와 다른 접근을 취한다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
// Claude의 SSE 포맷 — 표준에 더 가까운 구조
event: message_start
data: {"type":"message_start","message":{"id":"msg_01G...","model":"claude-opus-4-6",...}}

event: content_block_start
data: {"type":"content_block_start","index":0,"content_block":{"type":"text","text":""}}

event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"안녕"}}

event: content_block_delta
data: {"type":"content_block_delta","index":0,"delta":{"type":"text_delta","text":"하세요"}}

event: ping
data: {"type":"ping"}

event: content_block_stop
data: {"type":"content_block_stop","index":0}

event: message_stop
data: {"type":"message_stop"}
Claude는 delta encoding 없이, 각 이벤트가 독립적인 delta 텍스트를 포함한다. ChatGPT의 JSON Patch보다 단순하지만, 클라이언트에서 텍스트를 누적 조합(concatenation)해야 한다.
3.4 ChatGPT vs Claude 비교
| ChatGPT | Claude | |
|---|---|---|
| HTTP 버전 | h2 / h3 (환경에 따라 상이) | h2 / h3 (환경에 따라 상이) |
| SSE 포맷 | event: delta + JSON Patch | event: content_block_delta |
| Delta 전략 | 서버에서 Patch 연산 전달 | 클라이언트에서 텍스트 누적 |
| 재연결 | resume_conversation_token (JWT) | SDK retry만 지원, 스트림 재개 불가 |
| 하트비트 | : ping - timestamp (SSE 코멘트) | event: ping + JSON |
| 메타데이터 갱신 | "o":"replace" 로 diff | 별도 이벤트 (message_delta) |
| 대역폭 효율 | 🟢 O(n) delta | 🟡 O(n) 단순 append |
핵심 차이: ChatGPT는 대규모 트래픽에 최적화된 delta encoding으로 서버 출력 대역폭을 절감하고, Claude는 구현 단순성과 표준 호환성에 무게를 둔다. 두 접근 모두 text/event-stream 기반 SSE라는 점은 동일하다.
4. Last-Event-ID Deep Dive: 메시지 유실 방지 전략
4.1 Last-Event-ID 동작 원리
Last-Event-ID는 SSE 프로토콜에서 메시지 유실을 방지하는 핵심 메커니즘이다. HTML Living Standard(WHATWG)에 정의된 표준이다.
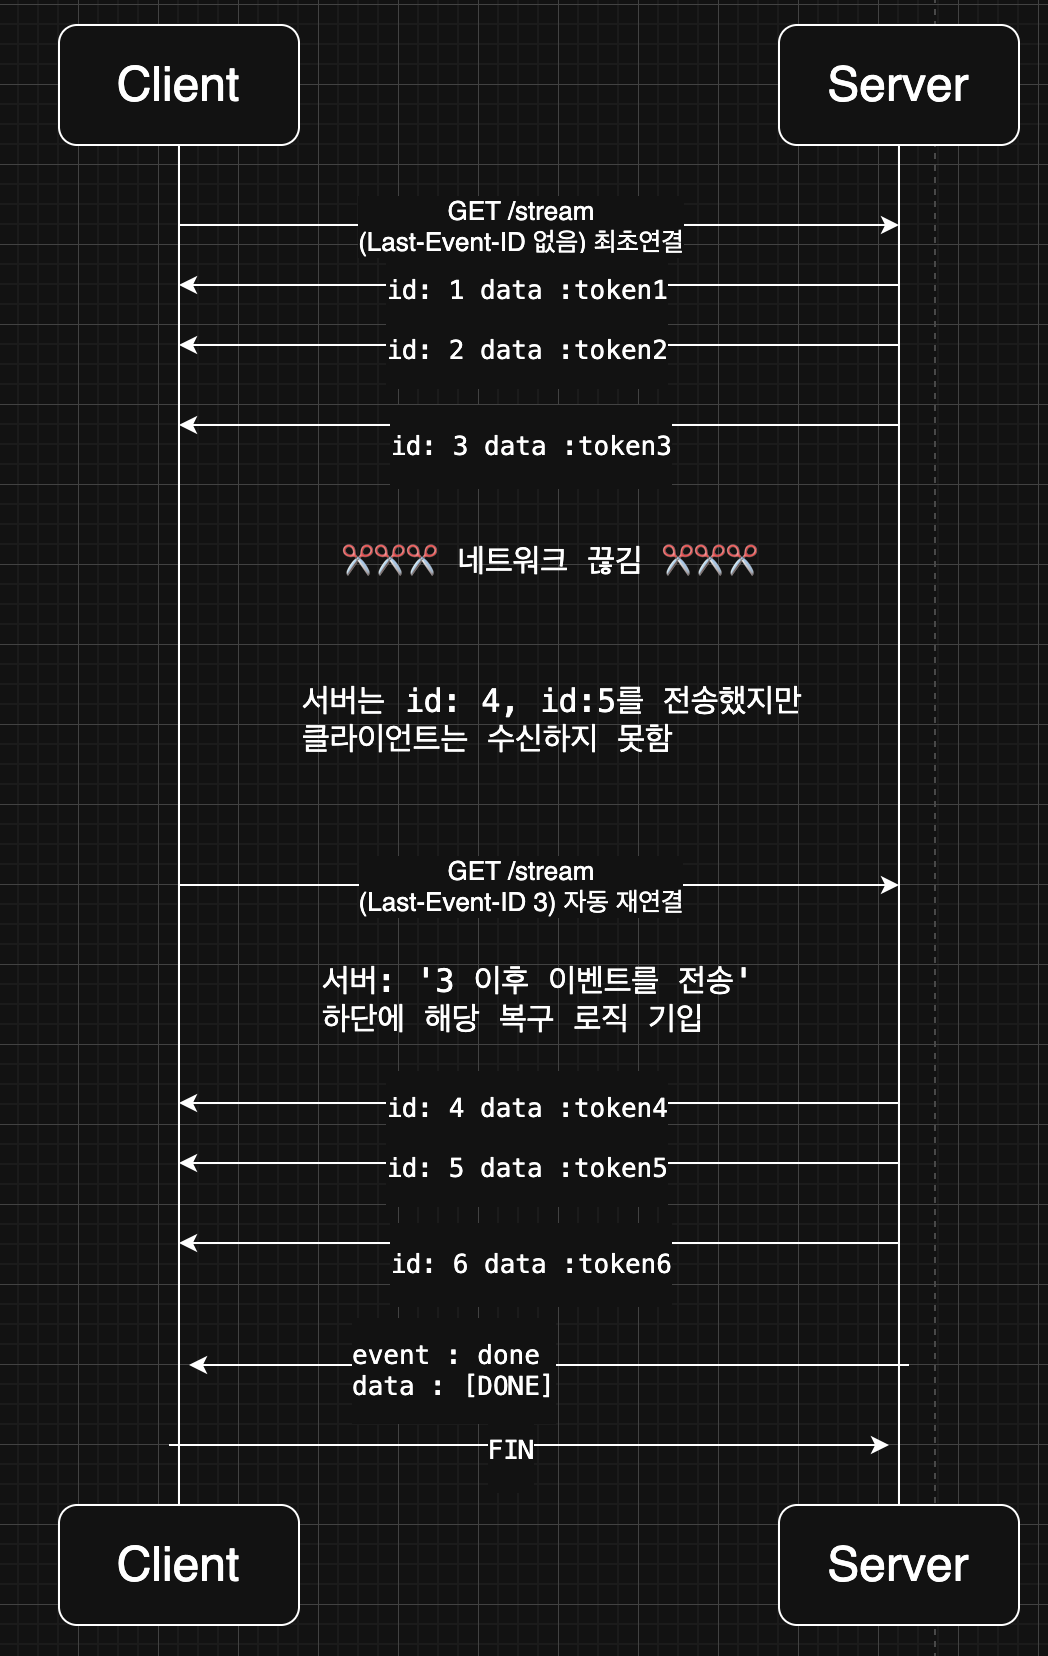 ▲ Last-Event-ID를 활용한 SSE 재연결 및 메시지 복구 흐름
EventSource API는 readyState로 연결 상태를 관리한다. 상태는 세 가지다.
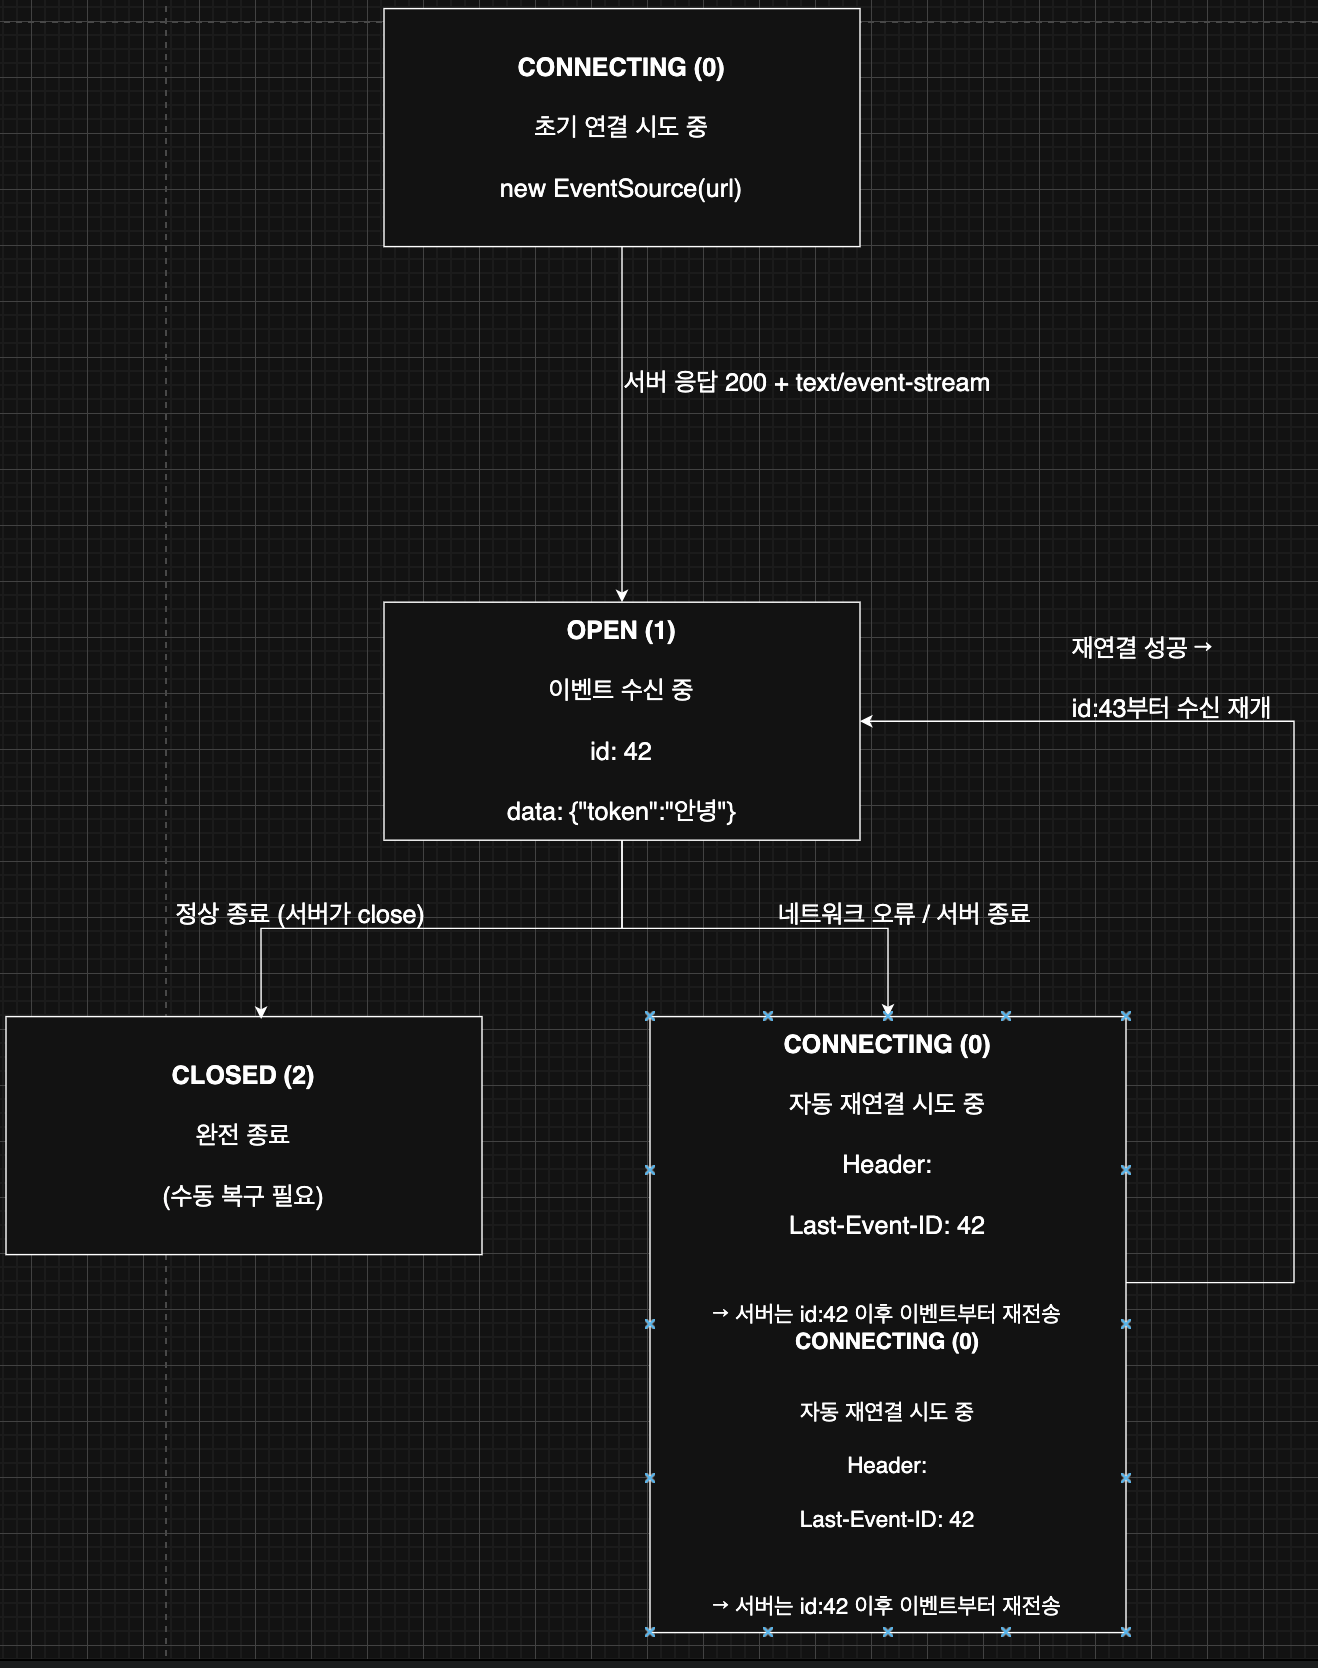 ▲ EventSource의 세 가지 readyState 상태 전이. CONNECTING(0) → OPEN(1) → CLOSED(2) 또는 자동 재연결
핵심은 OPEN → CONNECTING 전환 시 브라우저가 자동으로 Last-Event-ID 헤더를 포함한다는 것이다. 서버는 이 ID를 기준으로 놓친 이벤트만 재전송하면 된다. 연결이 끊기더라도 EventSource API가 재연결과 메시지 복구를 자동으로 처리하므로, 개발자가 별도로 구현할 필요가 없다.
WebSocket에는 이 메커니즘이 없다. 재연결 로직, 메시지 ID 관리, 놓친 메시지 복구를 모두 직접 구현해야 한다.
출처: MDN EventSource.readyState
4.2 서버 측 Last-Event-ID 관리: Mysql + Redis 조합
서버에서 Last-Event-ID를 관리하려면, 전송한 이벤트의 이력을 보관해야 한다. 인메모리(로컬)만으로는 다음 문제가 발생한다.
1
2
3
4
인메모리만 사용할 때의 문제:
  - 서버 재시작 → 이벤트 이력 전부 유실
  - 멀티 인스턴스 → 인스턴스 간 이력 공유 불가
  - 재연결 시 다른 인스턴스에 붙으면 → Last-Event-ID로 복구 불가능!
프로덕션에서는 주로 단일 서버로만 구동 되는것이 아니기 떄문에 k8s 환경하에 pod가 scaling out 되는 케이스에서는
인메모리(로컬)이아닌 외부 저장소를 통해 해당 데이터의 일관성을 보장해야한다
따라서 Redis(빠른 조회) + Mysql(영속성 보장) 조합으로 스케일링 환경을 구축한다면 아래와 같은 다이어그램으로 구축이 가능하다.
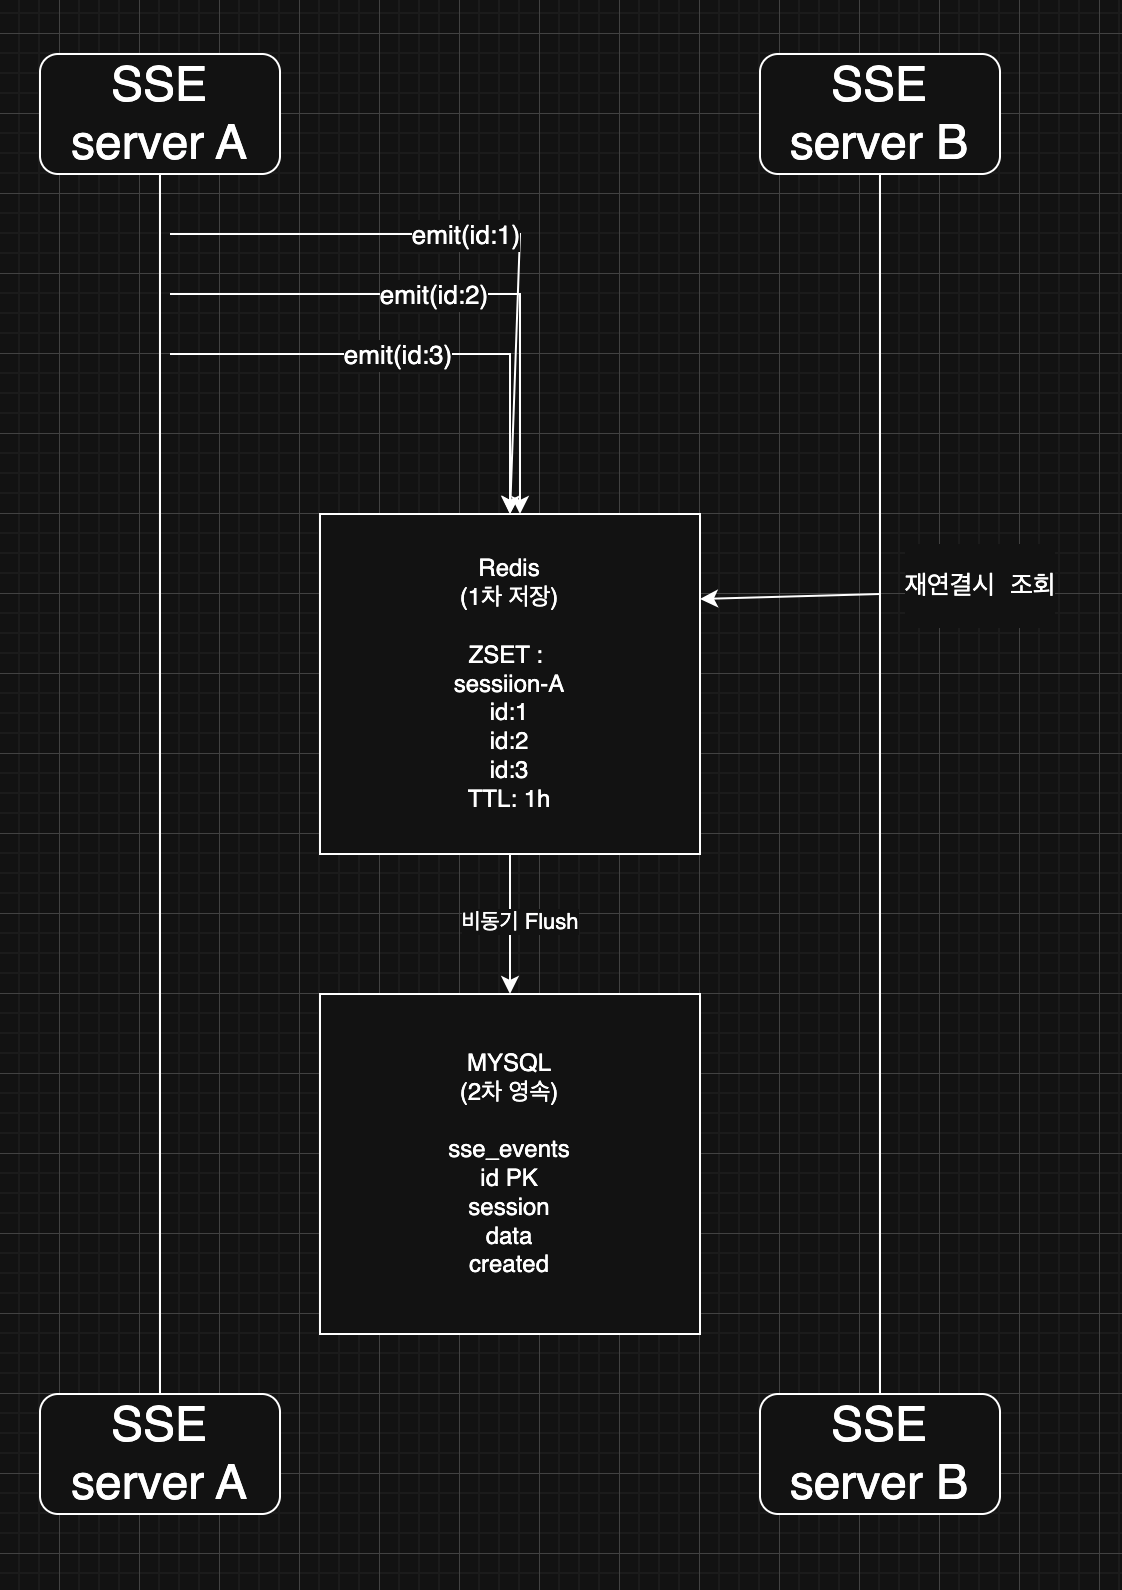 ▲ Redis + MySQL 조합의 Last-Event-ID 관리 아키텍처. Pod가 스케일아웃되어도 이벤트 이력 공유 가능
Redis — 1차 저장 (실시간 조회용)
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
@Service
public class RedisEventStoreService {

    private final StringRedisTemplate redisTemplate;
    private static final Duration EVENT_TTL = Duration.ofHours(1);

    /**
     * 이벤트 발행 시 Redis Sorted Set에 저장.
     * Score = timestamp로 시간순 정렬 보장.
     */
    public void store(String sessionId, SSEEvent event) {
        String key = "sse:events:" + sessionId;
        redisTemplate.opsForZSet().add(key, toJson(event), event.timestamp());
        redisTemplate.expire(key, EVENT_TTL);
    }

    /**
     * Last-Event-ID 이후의 이벤트를 조회.
     * 재연결 시 놓친 이벤트를 빠르게 반환.
     */
    public List<SSEEvent> getEventsSince(String sessionId, String lastEventId) {
        String key = "sse:events:" + sessionId;
        double lastTimestamp = getTimestamp(sessionId, lastEventId);

        Set<String> missed = redisTemplate.opsForZSet()
            .rangeByScore(key, lastTimestamp, Double.MAX_VALUE);

        return missed.stream()
            .map(this::fromJson)
            .filter(e -> !e.id().equals(lastEventId))  // 마지막 ID 자체는 제외
            .toList();
    }
}
MySQL — 2차 저장 (영속성 + 감사 로그)
1
2
3
4
5
6
7
8
9
CREATE TABLE sse_events (
    id          VARCHAR(64)  PRIMARY KEY,
    session_id  VARCHAR(64)  NOT NULL,
    event_type  VARCHAR(32)  NOT NULL,
    data        TEXT         NOT NULL,
    created_at  TIMESTAMP(3) NOT NULL DEFAULT CURRENT_TIMESTAMP(3),

    INDEX idx_session_created (session_id, created_at)
) ENGINE=InnoDB;
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
@Service
public class MySQLEventStoreService {

    private final SSEEventRepository repository;

    /**
     * Redis에서 조회 실패 시 (TTL 만료 등) MySQL에서 폴백 조회.
     */
    public List<SSEEvent> getEventsSince(String sessionId, String lastEventId) {
        return repository.findBySessionIdAndIdGreaterThan(sessionId, lastEventId);
    }

    /**
     * Redis 이벤트를 비동기로 MySQL에 flush.
     * @Scheduled 또는 Kafka Consumer에서 배치 처리.
     */
    @Async
    public void flushToMySQL(List<SSEEvent> events) {
        repository.saveAll(events);
    }
}
조회 흐름 — Redis 우선, MySQL 폴백:
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
@Service
public class EventStoreService {

    private final RedisEventStoreService redis;
    private final MySQLEventStoreService mysql;

    public List<SSEEvent> getEventsSince(String sessionId, String lastEventId) {
        // 1차: Redis에서 조회 (빠름, TTL 내)
        List<SSEEvent> events = redis.getEventsSince(sessionId, lastEventId);

        if (!events.isEmpty()) {
            return events;
        }

        // 2차: Redis에 없으면 MySQL 폴백 (TTL 만료 or Redis 장애)
        return mysql.getEventsSince(sessionId, lastEventId);
    }
}
왜 이 조합인가:
| 인메모리 | Redis만 | MySQL만 | Redis + MySQL | |
|---|---|---|---|---|
| 조회 속도 | 🟢 최고 | 🟢 빠름 | 🔴 느림 | 🟢 빠름 (Redis 우선) |
| 서버 재시작 | ❌ 유실 | ✅ 유지 | ✅ 유지 | ✅ 유지 |
| 멀티 인스턴스 | ❌ 공유 불가 | ✅ 공유 | ✅ 공유 | ✅ 공유 |
| 장기 보관 | ❌ | ⚠️ TTL 한계 | ✅ 무제한 | ✅ 무제한 |
| 감사 로그 | ❌ | ❌ | ✅ | ✅ |
| Redis 장애 시 | - | ❌ 전체 장애 | - | ✅ MySQL 폴백 |
5. SSE 서버는 언제 힘이 들까?
5.1 SSE 서버의 두 가지 부하 축
1
2
SSE 서버 부하 = Active Connections × Event Emit Speed
               (활성 커넥션 수)      (이벤트 발행 속도)
LLM 스트리밍은 Event Emit Speed가 매우 높다. TPS 30이면 클라이언트 하나당 초당 30개 이벤트가 발생한다. 1,000명 동시 사용 시 초당 3만 이벤트를 처리해야 한다. 이 영역에서는 스레딩 모델의 효율성(Virtual Thread, WebFlux 등)과 delta encoding을 통한 출력 대역폭 절감이 핵심이 된다.
5.2 Event Emit Speed를 효율화하는 방법
Event Emit Speed를 줄이는 접근은 크게 두 가지다.
방법 1: Delta Encoding — 변경된 데이터만 전송
3.2절에서 다뤘듯이, ChatGPT가 채택한 방식이다. 매 이벤트마다 전체 상태를 보내는 대신, 변경분(diff)만 전송하면 이벤트 크기가 토큰 수와 무관하게 일정하게 유지된다.
1
2
Full State:  토큰 200개 누적 → 마지막 이벤트 ~2,000 bytes
Delta:       토큰 200개 누적 → 마지막 이벤트 ~12 bytes (새 토큰만)
LLM 스트리밍처럼 토큰이 누적되는 구조에서는 이 차이가 동시 접속자 수에 비례해서 증폭된다. 서버 출력 대역폭을 직접적으로 줄이는 가장 효과적인 방법이다.
방법 2: MongoDB Change Stream — 변경 감지 기반 전송
MongoDB의 Change Stream은 컬렉션에서 변경된 document만 실시간으로 감지해서 전달한다. 알림 시스템처럼 “DB에 새 데이터가 들어오면 클라이언트에 push”하는 패턴에서는 매우 유의미하다 — 폴링 없이 변경 이벤트만 구독하면 되기 때문이다.
다만 LLM 스트리밍의 경우, 토큰 생성 → 클라이언트 전송 경로에 DB가 끼어있지 않는 경우가 많다. 현재 내 아키텍처에서는 Kafka를 메시지 큐로 사용하고 있어서, 토큰은 Kafka Consumer → SSE Emitter 경로로 전달된다. Change Stream이 개입할 지점이 없으므로 직접적인 효율 개선은 기대하기 어렵다.
1
2
3
4
5
6
7
8
9
LLM 스트리밍 경로 (현재 아키텍처):
  vLLM → Kafka Producer → Kafka Topic → Consumer → SSE Emitter → Client
                                                   ↑
                                          Delta Encoding 적용 지점

알림 시스템 경로 (Change Stream이 유효한 케이스):
  Service → MongoDB Insert → Change Stream → SSE Emitter → Client
                             ↑
                    변경 감지 + 필터링 지점
정리하면, Delta Encoding은 LLM 스트리밍에 직접적인 효율 개선을, Change Stream은 DB 기반 실시간 알림에 적합한 최적화를 제공한다. 어떤 방법이 유효한지는 이벤트가 발생하는 경로에 따라 달라진다.
6. 마무리: 왜 SSE인가
의사결정 요약
| 결정 | 선택 | 이유 |
|---|---|---|
| 스트리밍 프로토콜 | SSE | 단방향 최적. HTTP 기반 인프라 호환. Last-Event-ID 내장. HTTP 발전 자동 수혜 |
| 이벤트 유실 방지 | Last-Event-ID + Redis + MySQL | 재연결 시 놓친 이벤트 복구. 멀티 인스턴스 공유. 영속성 보장 |
| 대역폭 최적화 | Delta Encoding | Full State O(n²) → Delta O(n). 대규모 트래픽에서 서버 출력 16배+ 절감 |
핵심 정리
| 개념 | 기억할 포인트 |
|---|---|
| SSE vs WebSocket | LLM은 단방향 → SSE 최적. WebSocket은 오버엔지니어링 |
| HTTP 버전별 | HTTP/2: 연결 6→100. HTTP/3: HOL 해소 + 0-RTT + Migration |
| Delta Encoding | Full State는 O(n²), Delta는 O(n). ChatGPT가 이 방식 사용 |
| Last-Event-ID | SSE 표준의 유실 방지. Redis(실시간) + MySQL(영속) 조합 |
| 실제 서비스 | ChatGPT: h3 + delta. Claude: 표준 SSE. 둘 다 text/event-stream |
참고 자료
- WHATWG HTML Living Standard: Server-Sent Events — html.spec.whatwg.org/multipage/server-sent-events.html
- MDN Web Docs: Using Server-Sent Events — developer.mozilla.org/en-US/docs/Web/API/Server-sent_events
- RFC 9000: QUIC — datatracker.ietf.org/doc/html/rfc9000
- RFC 8441: Bootstrapping WebSockets with HTTP/2 — datatracker.ietf.org/doc/html/rfc8441
- RFC 6902: JSON Patch — datatracker.ietf.org/doc/html/rfc6902
- Anthropic Streaming API — docs.claude.com/en/docs/build-with-claude/streaming
- 이전 글: vLLM 인퍼런스 서버 구축과 벤치마크
- 우아한형제들 기술블로그, “더 빠르고 안정적인 알림을 위한 SSE 적용기” — techblog.woowahan.com/23199
- 지금 이순간, 재고는 줄고 있다 실시간 UI 경험을 위한 SSE 여정 — https://www.youtube.com/watch?v=vEyrAWafm64