[LLM Serving] vLLM 인퍼런스 서버 구축과 벤치마크: Continuous Batching은 얼마나 빠른가?
들어가며
1
2
curl http://localhost:8000/v1/chat/completions \
  -d '{"model": "Qwen2.5-7B", "messages": [{"role": "user", "content": "한국의 수도는?"}]}'
위 요청 하나는 57ms 만에 첫 토큰을 반환한다. 그런데 동시에 50명이 같은 요청을 보내면 어떻게 될까?
일반적인 API 서버와 달리, LLM 인퍼런스 서버는 요청 하나당 수 GB의 GPU 메모리를 소모한다. 이 글에서는 vLLM을 직접 구축하고, Continuous Batching이 실제로 throughput을 얼마나 개선하는지, 양자화(Quantization)는 항상 좋은 선택인지를 실측 데이터로 확인한다.
특히 “FP16과 AWQ 중 뭐가 빠른가?”에 대해 “상황에 따라 다르다”는 답을 직접 수치로 증명해보겠다.
목차
- LLM 인퍼런스 서버가 일반 API 서버와 다른 이유
- vLLM 서버 구축: FP16 vs AWQ INT4
- Continuous Batching vs Static Batching 비교
- KV Cache 부족 상황 시뮬레이션: Preemption 관찰
- QLoRA 학습 파이프라인: 데이터 수집부터 LoRA 서빙까지
- 마무리: LLM 서빙은 트레이드오프의 연속이다
1. LLM 인퍼런스 서버가 일반 API 서버와 다른 이유
1.1 일반 API 서버와의 차이
일반적인 Spring Boot 서버에서 REST API 하나를 처리하는 비용은 CPU + 메모리 수십 MB 수준이다. 동시 요청이 늘어나면 Thread Pool을 늘리거나, HPA로 Pod를 추가하면 된다.
LLM 인퍼런스 서버는 근본적으로 다르다.
1
2
3
4
5
6
7
일반 API 서버:
  요청 1건 = CPU 연산 + 메모리 ~50MB
  동시 100건 = Thread 100개 → ~5GB

LLM 인퍼런스 서버:
  요청 1건 = GPU 연산 + KV Cache ~수백MB~수GB
  동시 100건 = KV Cache만 수십~수백GB → GPU 메모리 폭발
1.2 KV Cache: 왜 요청당 메모리가 큰가?
LLM은 토큰을 하나씩 생성(Autoregressive)할 때, 이전 토큰들의 Key-Value를 재사용해야 한다. 이걸 매번 다시 계산하면 O(n²)이 되므로, KV Cache에 저장해두고 재사용한다.
1
2
3
4
KV Cache 크기 = 2 × layers × kv_heads × head_dim × seq_len × dtype_bytes

예시: Qwen2.5-7B (GQA: 28 attention heads, 4 kv heads), seq_len=4096, FP16
= 2 × 28 × 4 × 128 × 4096 × 2bytes ≈ 224MB (요청 1건)
요청당 224MB는 작아 보이지만, seq_len이 32K로 늘면 ~1.8GB, 128K면 ~7.2GB로 선형 증가한다. 동시 50명 × 32K context면 KV Cache만 ~90GB — A100 80GB 한 장으로는 부족하다. 이 문제를 어떻게 해결하는지가 LLM 서빙의 핵심이다.
1.3 PagedAttention: OS의 Virtual Memory에서 답을 찾다
vLLM은 이 KV Cache 메모리 문제를 OS의 가상 메모리 관리에서 영감을 받아 해결했다. 기존 방식은 요청이 들어오면 max_seq_len 전체에 해당하는 KV Cache를 한 번에 연속 할당했다. 실제로는 50토큰만 생성하더라도 4096토큰분의 메모리를 점유하는 것이다. 이 내부 단편화(Internal Fragmentation)로 인해 GPU 메모리의 60~70%가 낭비된다.
PagedAttention은 KV Cache를 고정 크기의 블록(Page)으로 나누고, 토큰이 생성될 때마다 필요한 만큼만 블록을 할당한다. OS가 물리 메모리를 페이지 단위로 관리하듯, vLLM은 GPU 메모리를 블록 단위로 관리한다.
1
2
3
4
5
6
7
8
9
10
기존 방식 (Static Allocation):
  요청 A: [████████████████____] ← 4096토큰 예약, 실제 사용 3000
  요청 B: [████████████________] ← 4096토큰 예약, 실제 사용 2000
  → 빈 공간이 있어도 연속 메모리 부족으로 요청 C 거절

PagedAttention (Dynamic Paging):
  요청 A: [██][██][██][██]      ← 필요한 블록만 할당
  요청 B: [██][██][██]          ← 필요한 블록만 할당
  요청 C: [██][██]              ← 남은 블록으로 수용 가능
  → 메모리 낭비 없이 더 많은 동시 요청 처리
이 구조 덕분에 동일 GPU에서 처리할 수 있는 동시 요청 수가 2~4배 늘어난다. 2장에서 nvidia-smi로 확인할 vLLM의 메모리 사용 패턴이 바로 이 PagedAttention의 결과다.
2. vLLM 서버 구축: FP16 vs AWQ INT4
2.1 실험 환경
| 항목 | 스펙 |
|---|---|
| GPU | NVIDIA A40 48GB |
| CUDA | 12.8 |
| vLLM | 최신 버전 (pip install) |
| 모델 | Qwen/Qwen2.5-7B-Instruct |
| 양자화 모델 | Qwen/Qwen2.5-7B-Instruct-AWQ |
| max-model-len | 4096 |
| gpu-memory-utilization | 0.9 |
2.2 FP16 서빙
1
2
3
4
5
python -m vllm.entrypoints.openai.api_server \
  --model Qwen/Qwen2.5-7B-Instruct \
  --max-model-len 4096 \
  --gpu-memory-utilization 0.9 \
  --port 8000
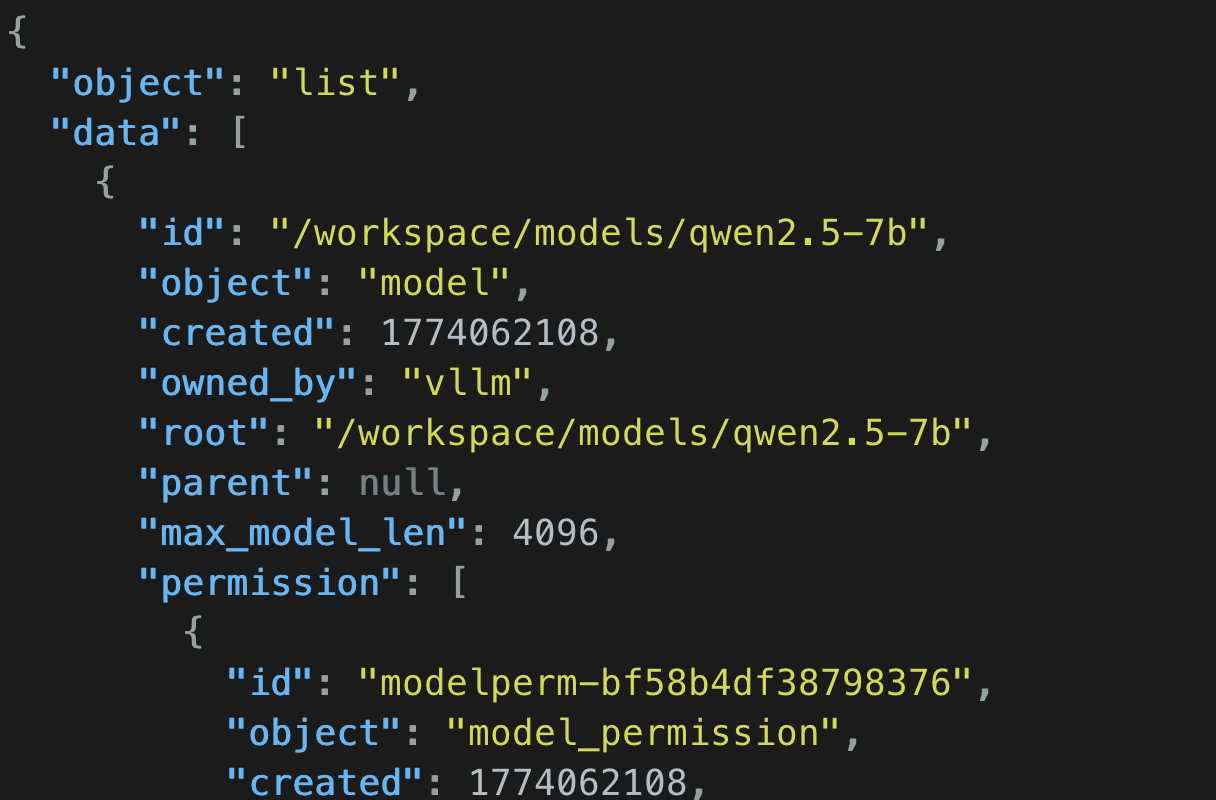 ▲ FP16 모델 로딩 후 nvidia-smi. 모델 가중치 14GB + KV Cache 예약으로 약 41.8GB 사용
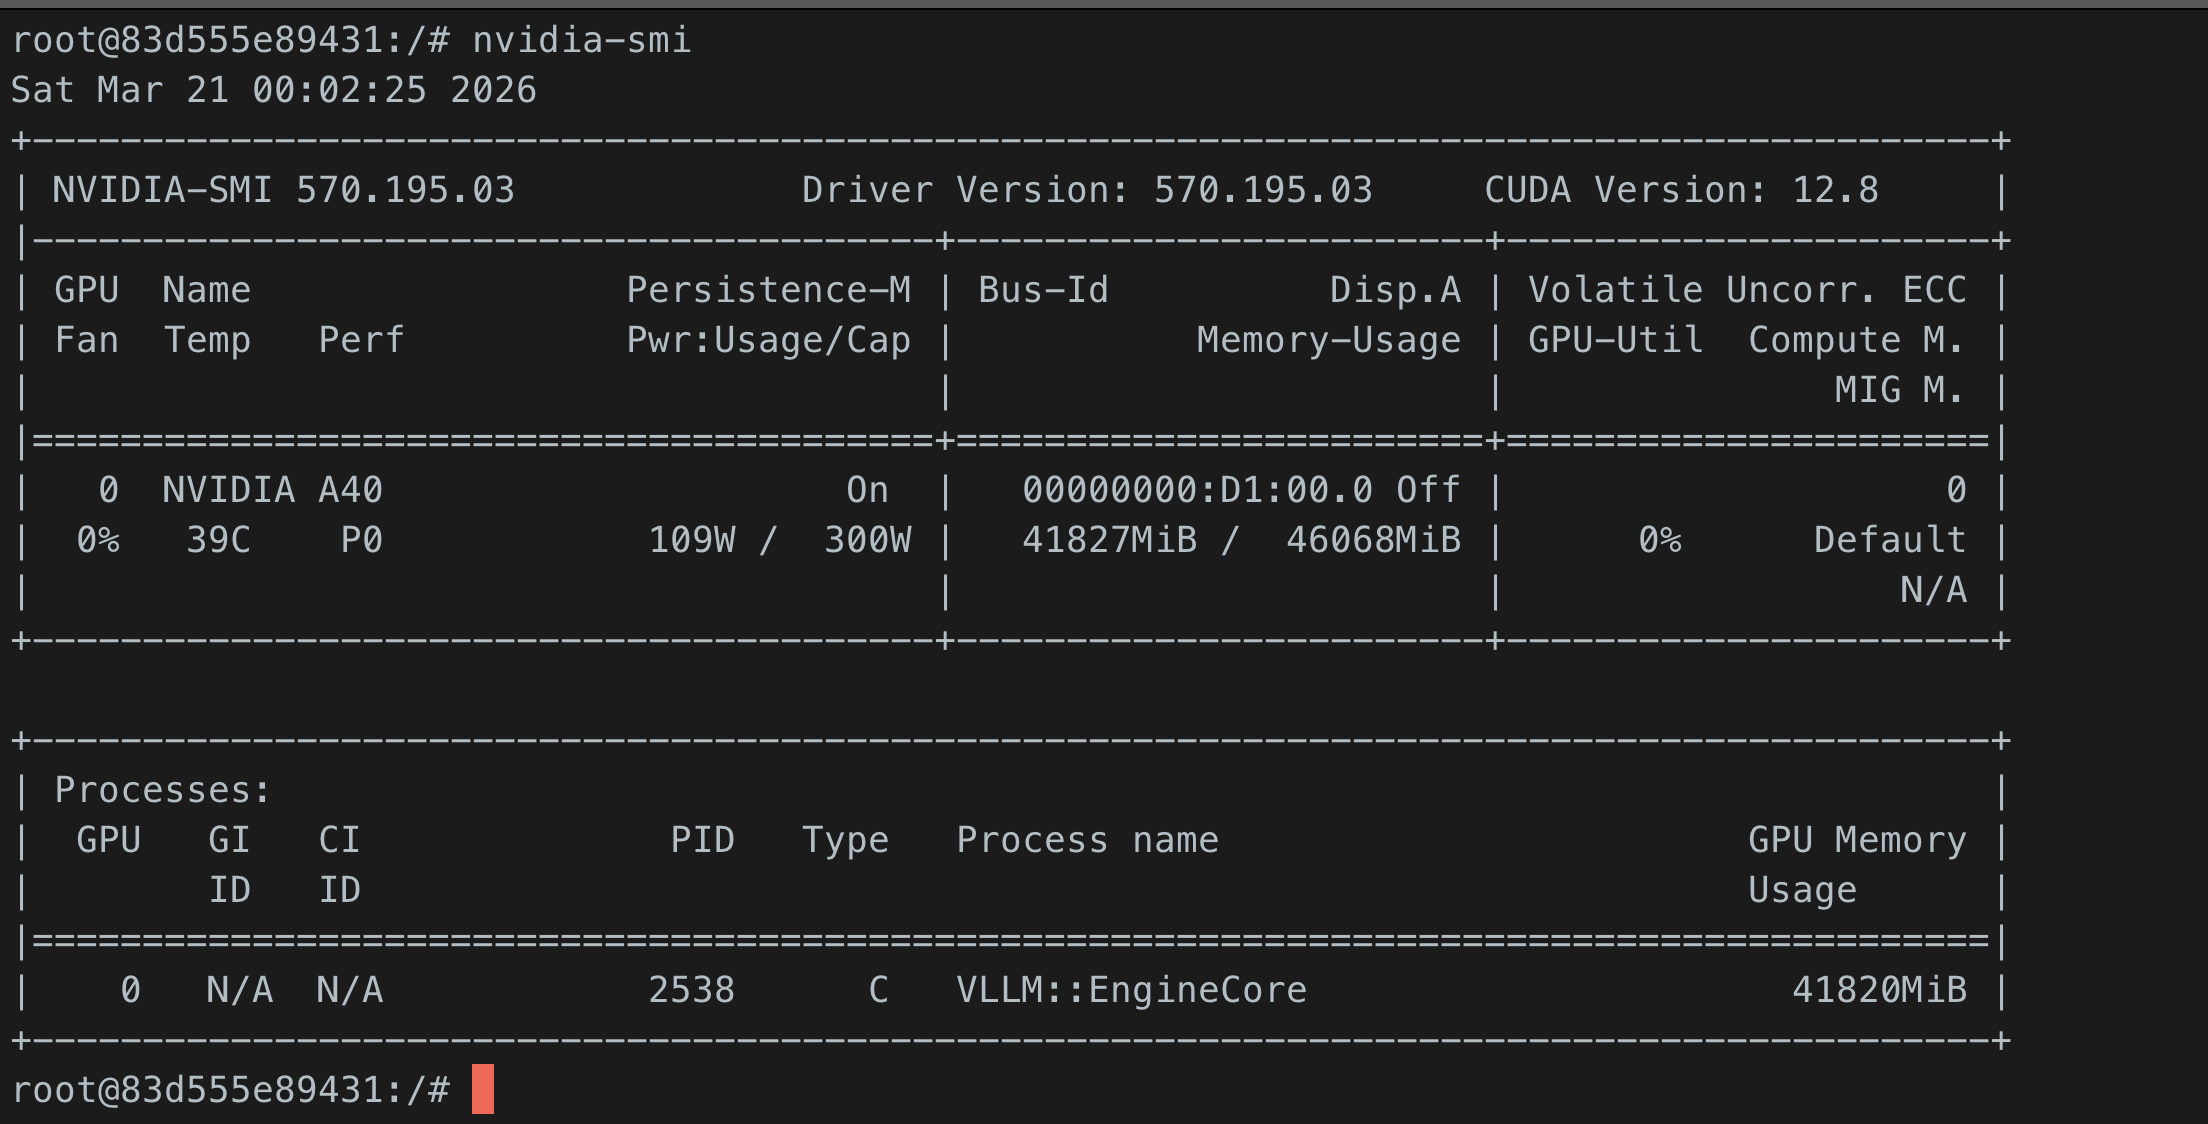 ▲ nvidia-smi로 확인한 A40 48GB GPU 정보. VRAM 46GB 사용 가능
서버 구동 후 nvidia-smi를 확인하면 약 41.8GB / 46GB를 사용한다. 모델 가중치 자체는 약 14GB이지만, vLLM이 --gpu-memory-utilization 0.9 설정에 따라 나머지 27GB를 KV Cache로 미리 예약한 것이다. 이게 PagedAttention이 작동하는 방식이다.
2.3 FP16 모델 리소스
1
2
3
4
5
6
7
8
9
10
11
12
13
14
python -c "
import torch
from transformers import AutoModelForCausalLM
print('=== FP16 모델 로딩 ===')
model = AutoModelForCausalLM.from_pretrained(
    '/workspace/models/qwen2.5-7b',
    torch_dtype=torch.float16,
    device_map='auto'
)
mem = torch.cuda.memory_allocated() / 1e9
print(f'FP16 GPU 메모리: {mem:.1f}GB')
del model
torch.cuda.empty_cache()
"
 ▲ FP16 모델 로딩 시 GPU 메모리 사용량. Qwen2.5-7B 전체 가중치가 약 14GB를 차지
2.4 AWQ INT4 모델 리소스
1
2
3
4
5
6
7
8
9
10
11
12
13
python -c "
import torch
from transformers import AutoModelForCausalLM, BitsAndBytesConfig
print('=== AWQ 4bit 모델 로딩 ===')
bnb = BitsAndBytesConfig(load_in_4bit=True, bnb_4bit_quant_type='nf4', bnb_4bit_compute_dtype=torch.float16)
model = AutoModelForCausalLM.from_pretrained(
    '/workspace/models/qwen2.5-7b',
    quantization_config=bnb,
    device_map='auto'
)
mem = torch.cuda.memory_allocated() / 1e9
print(f'4bit GPU 메모리: {mem:.1f}GB')
"
 ▲ AWQ 4bit 모델 로딩 시 GPU 메모리 사용량. 양자화로 가중치가 약 4.5GB로 줄어 KV Cache 여유 공간 확보
2.5 단일 요청 성능 비교
TTFT(Time To First Token)와 TPS(Tokens Per Second)를 측정했다.
1
2
3
4
5
6
7
# TTFT 측정 (streaming 모드)
start = time.time()
response = requests.post(url, json={...}, stream=True)
for line in response.iter_lines():
    if line:
        ttft = time.time() - start
        break
| 메트릭 | FP16 | AWQ INT4 | 비고 |
|---|---|---|---|
| TTFT (첫 토큰) | 57ms | 99ms | FP16이 42% 빠름 |
| TPS (초당 토큰) | 35.4 | 15.2 | FP16이 2.3배 빠름 |
| 총 응답 시간 (200토큰) | 5,671ms | 13,215ms | |
| GPU 메모리 (nvidia-smi) | ~41.8GB | ~42.3GB | 둘 다 0.9 예약 |
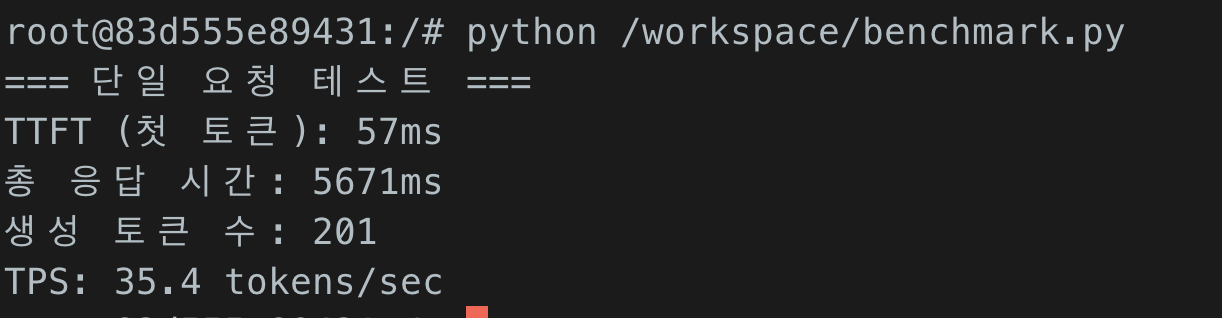 ▲ FP16 단일 요청 벤치마크 결과. TTFT 57ms, TPS 35.4로 빠른 응답 속도
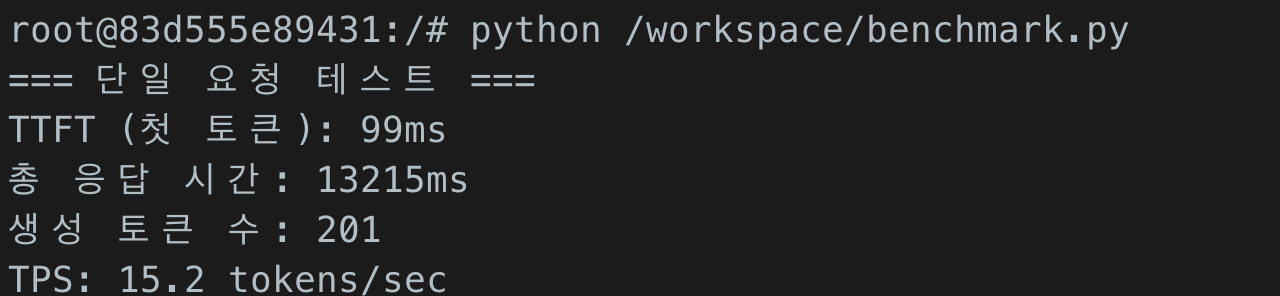 ▲ AWQ INT4 단일 요청 벤치마크 결과. TTFT 99ms, TPS 15.2로 dequantization 오버헤드 확인
2.6 “양자화하면 무조건 빠르다”는 틀렸다 — GPU 아키텍처에 따라 다르다
벤치마크 결과를 보면 AWQ INT4가 FP16보다 느렸다. 이유는 A40의 아키텍처 한계에 있다.
AWQ는 W4A16(Weight 4bit, Activation 16bit) 방식이다. 가중치만 INT4로 압축하고, 실제 연산은 FP16으로 수행한다. 문제는 Tensor Core가 양쪽 operand의 타입이 일치해야 동작한다는 것이다. 따라서 INT4 가중치를 FP16으로 변환(dequantization)하는 과정이 필요하다.
A40(Ampere)에서는 이 dequantization이 별도의 GPU 커널로 실행된다. GEMM 연산 전에 dequantization 커널이 먼저 실행되고, 그 결과를 메모리에 쓴 뒤, FP16 GEMM 커널이 다시 읽어서 연산한다. 커널 론치 오버헤드가 2배이고, 불필요한 메모리 왕복이 발생한다. 이것이 FP16 직접 연산보다 느린 근본 원인이다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
A40 (Ampere) — Dual Kernel:
[INT4 Weight] → Kernel 1: Dequantize → [FP16 Temp] → GPU Memory Write
              → GPU Memory Read → Kernel 2: FP16 GEMM
              → 커널 2회 론치 + 메모리 왕복 = FP16보다 느림

Ada Lovelace (L4/L40S/RTX 4090) — Marlin Fused Kernel:
[INT4 Weight] → Single Kernel: Dequantize + GEMM (fused)
              → 커널 1회 + 메모리 왕복 없음 = FP16과 비슷하거나 소폭 빠름

Hopper (H100/H200) — FP8 Tensor Core:
[FP8 Weight + FP8 Activation] → Tensor Core 직접 연산
                               → Dequantization 자체가 불필요 = FP16 대비 ~1.6x 빠름

Blackwell (B200/RTX 5090) — NVFP4 Tensor Core:
[FP4 Weight + FP4 Activation] → 네이티브 4bit 연산
                               → 메모리 75% 절약 + 연산 2x+ 가속
핵심은 양자화의 효과가 GPU 아키텍처에 종속적이라는 것이다.
- A40 (Ampere): W4A16 dequantization 오버헤드로 FP16보다 느림. 양자화는 VRAM이 부족할 때 “모델을 올리기 위한 수단”으로만 의미 있음
- Ada Lovelace (L4, L40S, RTX 4090): Marlin 커널로 W4A16 오버헤드 최소화. 메모리 절약 효과를 속도 저하 없이 얻을 수 있음
- Hopper (H100): FP8 W8A8로 가중치+활성화 모두 양자화하면 Tensor Core가 직접 연산. 진정한 “양자화 = 속도 향상”
- Blackwell (B200): NVFP4로 4bit 네이티브 연산. 양자화가 메모리와 속도 모두에서 최적
결론: “양자화하면 빨라지나요?”
- A40에서: 아니오. 메모리가 부족할 때만 사용하세요.
- H100에서: 네. FP8이면 1.6배 빨라집니다.
- B200에서: 네. NVFP4면 2배 이상 빨라집니다.
양자화는 “메모리 최적화”인지 “연산 가속”인지, GPU가 결정한다.
출처: LLM 추론에 대한 NVFP4의 영향 - nvidia-blackwell
3. Continuous Batching vs Static Batching 비교
3.1 왜 배칭이 필요한가?
LLM 추론에서 요청을 하나씩 처리하면 GPU 활용률이 극도로 낮아진다. 여러 요청을 묶어서(Batch) 동시에 처리하면 GPU의 병렬 연산 능력을 활용할 수 있다.
Static Batching은 배치 내 가장 긴 요청이 끝날 때까지 다른 슬롯이 대기해야 한다. “안녕”(2토큰)과 “5000자 에세이”(500토큰)가 같은 배치에 있으면, “안녕”은 이미 끝났는데 GPU 자리를 점유한 채 기다린다.
Continuous Batching은 완료된 슬롯에 즉시 새 요청을 채워넣는다. GPU가 쉬지 않는다.
3.2 Static Batching 시뮬레이션
vLLM에는 Static Batching 모드가 없지만, --max-num-seqs 1로 설정하면 한 번에 1개 요청만 처리하므로 사실상 Static Batching과 동일한 효과를 낸다.
1
2
3
4
5
6
7
8
# Static Batching 시뮬레이션
python -m vllm.entrypoints.openai.api_server \
  --model Qwen/Qwen2.5-7B-Instruct-AWQ \
  --quantization awq \
  --max-num-seqs 1 \
  --max-model-len 4096 \
  --gpu-memory-utilization 0.9 \
  --port 8000
3.3 동시 요청 부하 테스트
ThreadPoolExecutor로 동시 1/10/50명 요청을 보내 RPS와 레이턴시를 측정했다.
1
2
3
4
5
6
from concurrent.futures import ThreadPoolExecutor, as_completed

for n_users in [1, 10, 50]:
    with ThreadPoolExecutor(max_workers=n_users) as executor:
        futures = [executor.submit(send_request, i) for i in range(n_users)]
        # RPS, P50, P99 계산
3.4 결과 비교
Continuous Batching (기본 설정)
| 동시 요청 | RPS | P50 | P99 | 실패율 |
|---|---|---|---|---|
| 1명 | 0.2 | 6,609ms | 6,609ms | 0% |
| 10명 | 1.5 | 6,860ms | 6,869ms | 0% |
| 50명 | 6.7 | 7,382ms | 7,420ms | 0% |
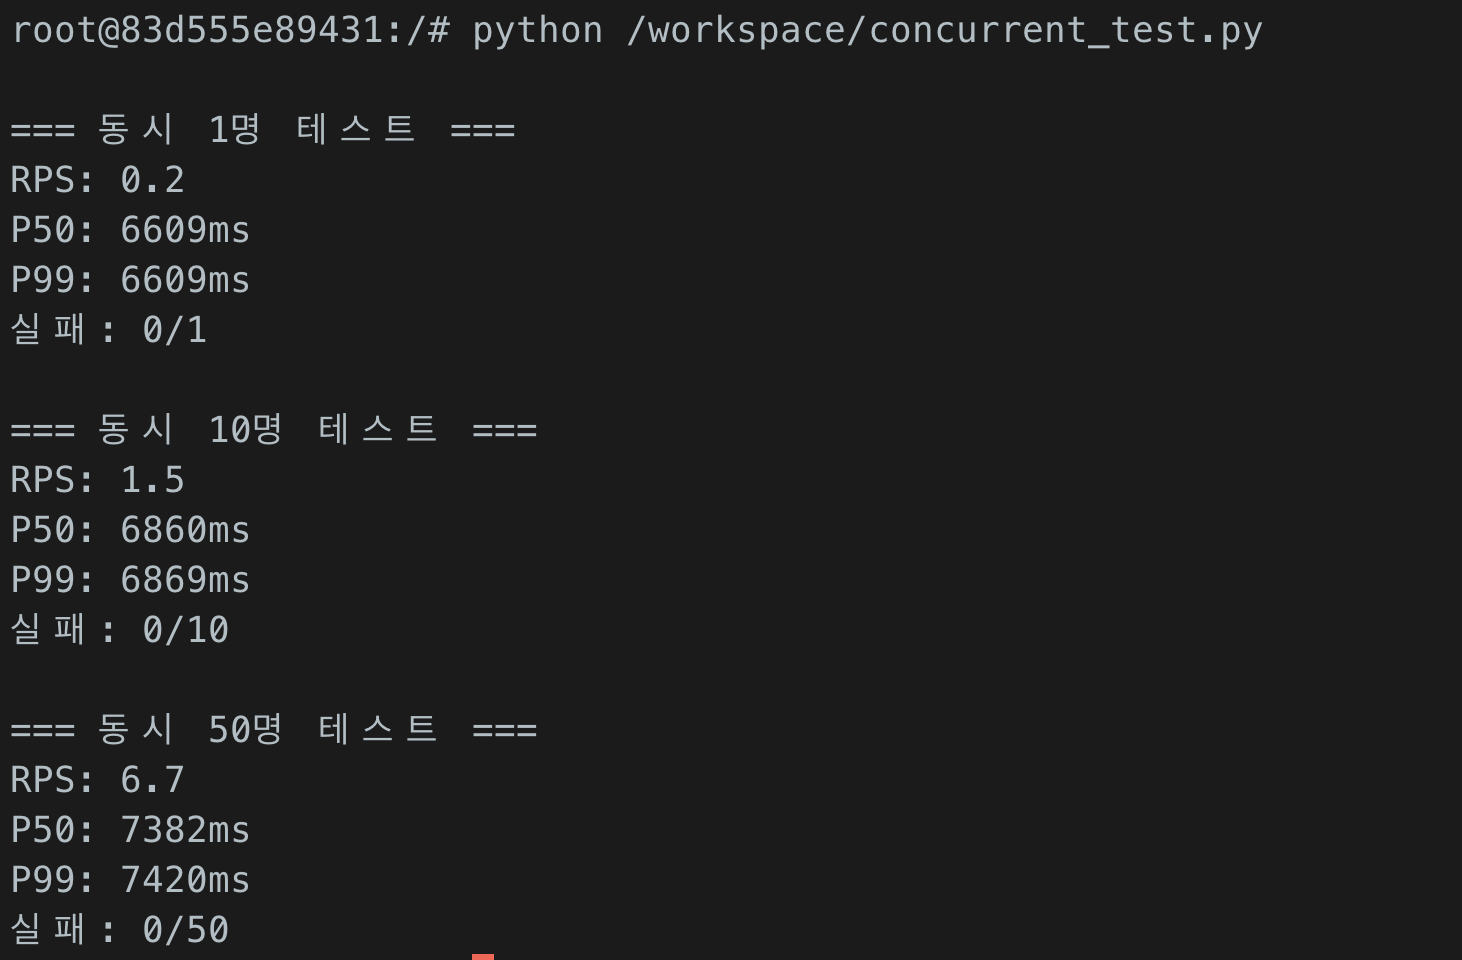 ▲ Continuous Batching 모드에서 동시 1/10/50명 부하 테스트 결과. 50명에서도 P99 7,420ms로 안정적
동시 요청 처리 중 nvidia-smi를 확인하면 GPU Utilization이 높게 유지되는 것을 볼 수 있다. Continuous Batching이 GPU를 쉬지 않게 만드는 것이다.
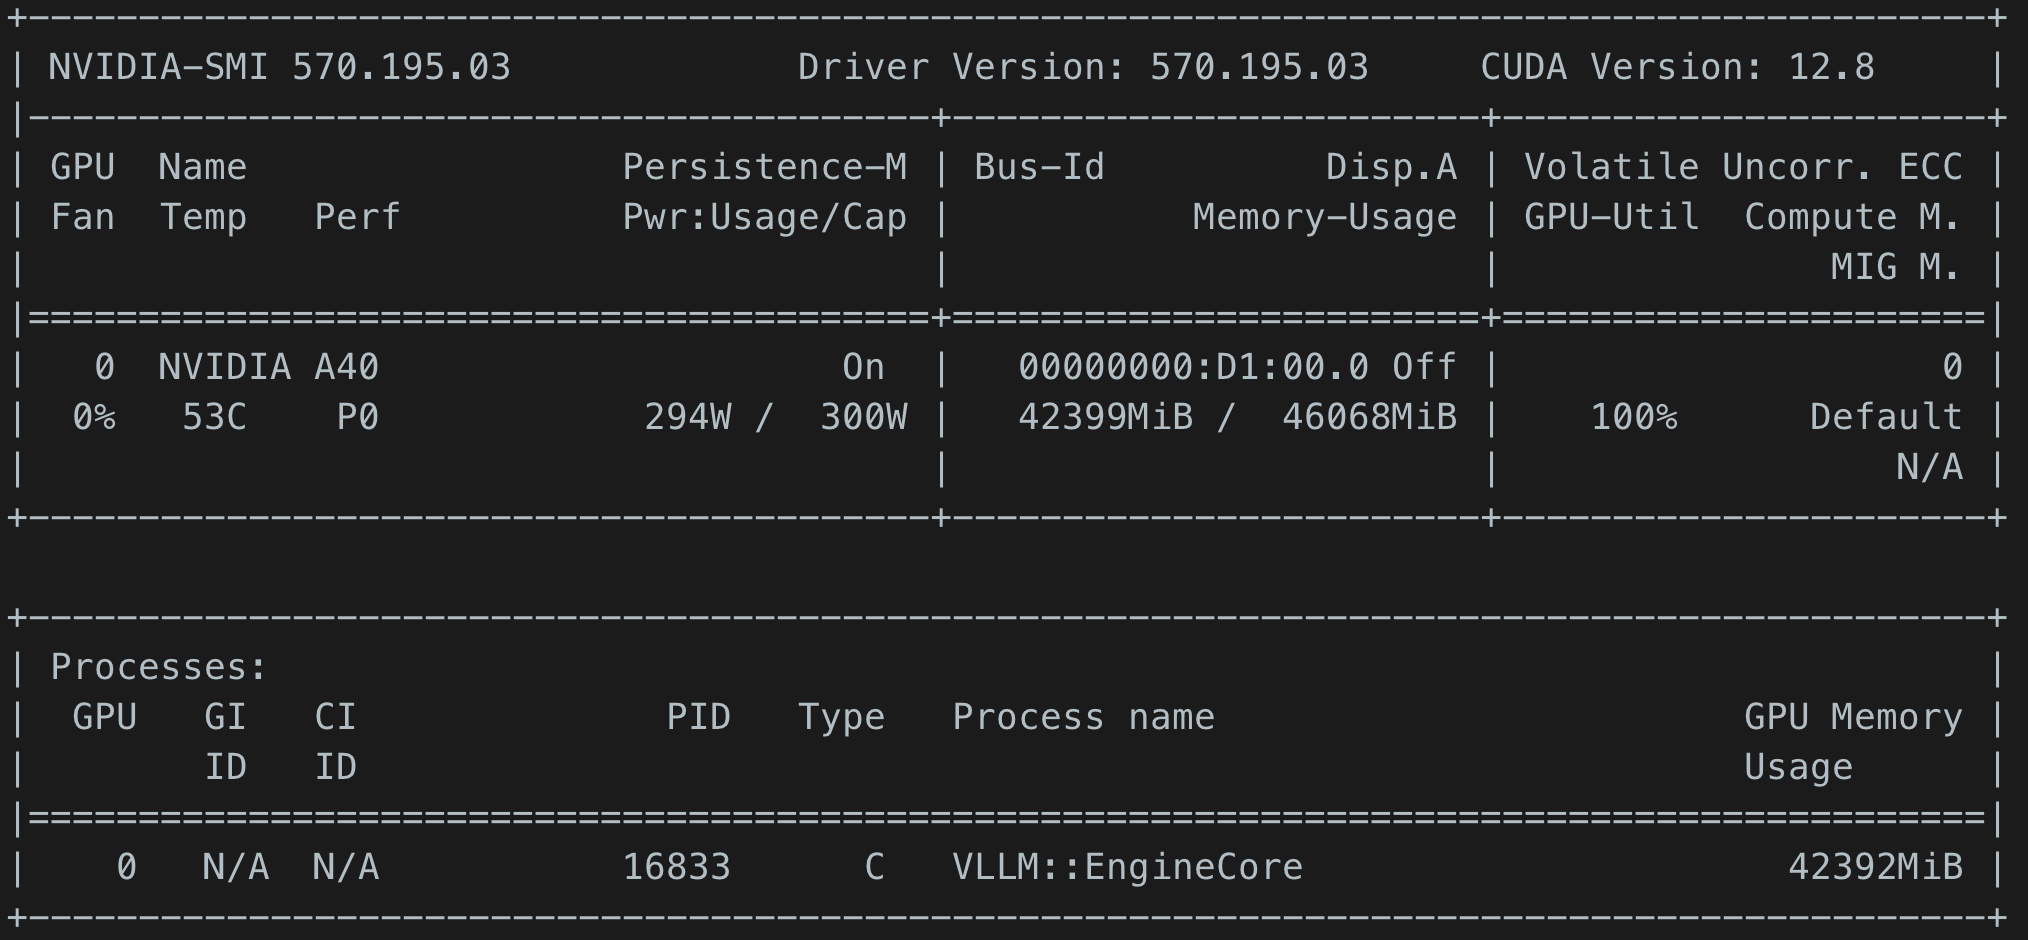 ▲ 동시 50명 요청 처리 중 nvidia-smi. GPU Utilization이 높게 유지되며 배칭 효과를 확인
Static Batching (max-num-seqs=1)
| 동시 요청 | RPS | P50 | P99 | 실패율 |
|---|---|---|---|---|
| 1명 | 1.0 | 999ms | 999ms | 0% |
| 10명 | 1.1 | 5,663ms | 9,414ms | 0% |
| 50명 | 1.1 | 24,475ms | 47,091ms | 0% |
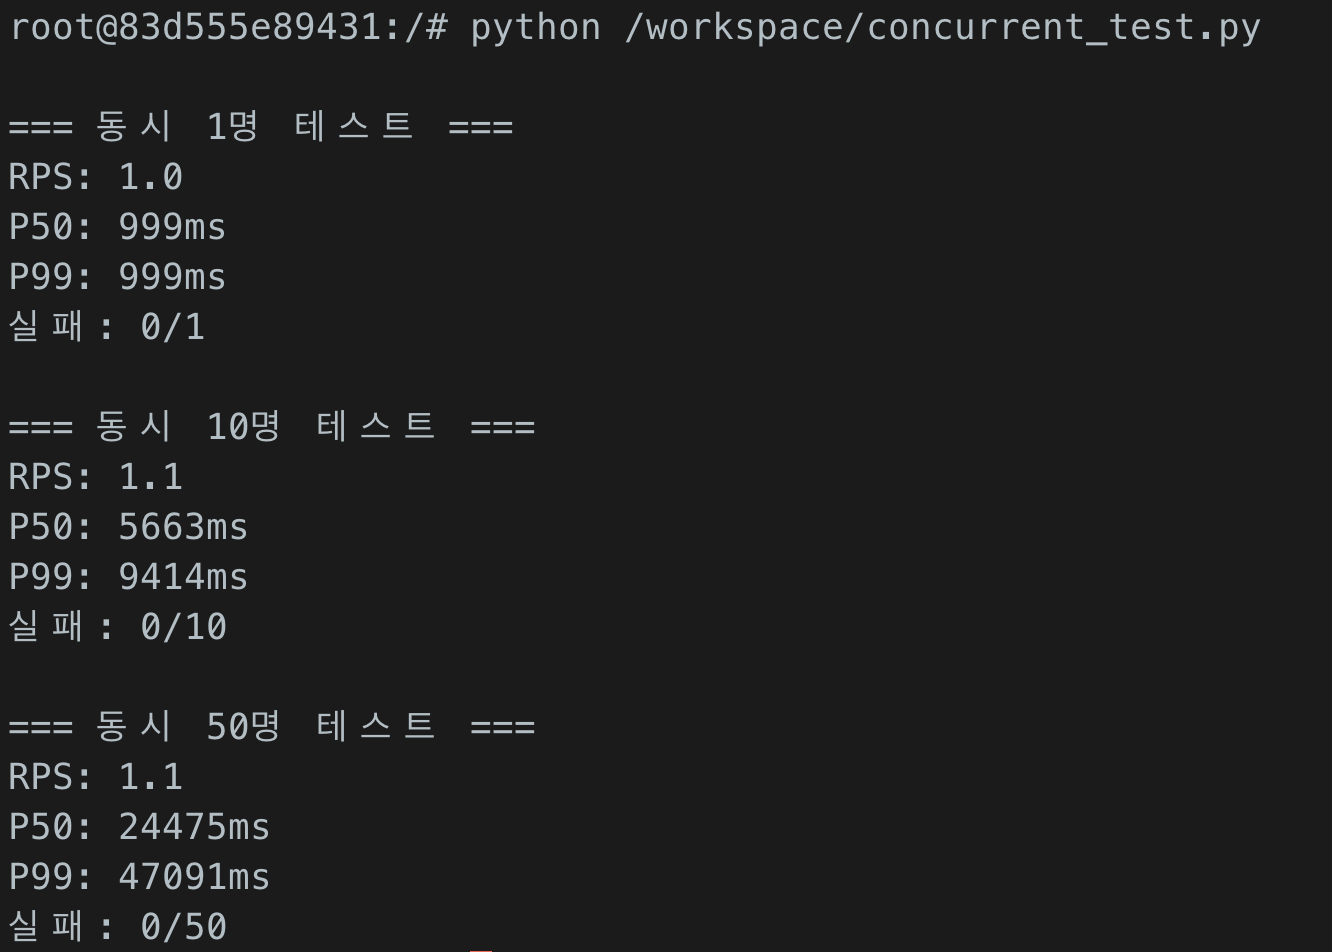 ▲ Static Batching(max-num-seqs=1) 모드에서 동시 요청 결과. 50명 기준 P99가 47초까지 치솟음
3.5 핵심 인사이트
1
2
3
동시 50명 기준:
- Throughput: 1.1 → 6.7 RPS (6.1배 향상)
- P99 Latency: 47,091ms → 7,420ms (84% 감소)
동시 요청이 50배 늘었는데 Continuous Batching의 레이턴시는 12%만 증가했다(6,609ms → 7,420ms). 반면 Static Batching은 요청이 순차 처리되면서 P99가 47초까지 치솟았다.
이것이 vLLM이 프로덕션 LLM 서빙에서 사실상 표준이 된 이유다. PagedAttention으로 KV Cache 메모리를 효율화하고, Continuous Batching으로 GPU 활용률을 극대화한다.
4. KV Cache 부족 상황 시뮬레이션: Preemption 관찰
4.1 프로덕션에서 왜 중요한가?
실제 서비스에서는 GPU 메모리가 항상 넉넉하지 않다. 동시 요청이 급증하면 KV Cache가 부족해지고, vLLM은 Preemption — 기존 요청의 KV Cache를 swap하고 새 요청을 받는 동작 — 을 수행한다.
이 상황을 관찰하기 위해 --gpu-memory-utilization 0.2로 KV Cache를 의도적으로 제한하고, 200명 동시 요청 + max_tokens=500의 긴 응답을 요구했다.
4.2 vLLM /metrics 엔드포인트
vLLM은 Prometheus 형식의 메트릭을 기본 제공한다.
1
curl http://localhost:8000/metrics | grep -E "num_requests|gpu_cache|num_preemption"
4.3 관찰 결과
충분한 KV Cache (gpu-memory-utilization=0.9, 50명)
1
2
3
vllm:num_requests_running  = 50.0   ← 전부 동시 처리
vllm:num_requests_waiting  = 0.0    ← 대기열 없음
vllm:num_preemptions_total = 0.0    ← preemption 없음
제한된 KV Cache (gpu-memory-utilization=0.2, 200명)
1
2
3
vllm:num_requests_running  = 184.0  ← 200개 중 184개만 처리 가능
vllm:num_requests_waiting  = 16.0   ← 16개가 대기열에 밀림
vllm:num_preemptions_total = 17.0   ← 17번 KV Cache swap 발생
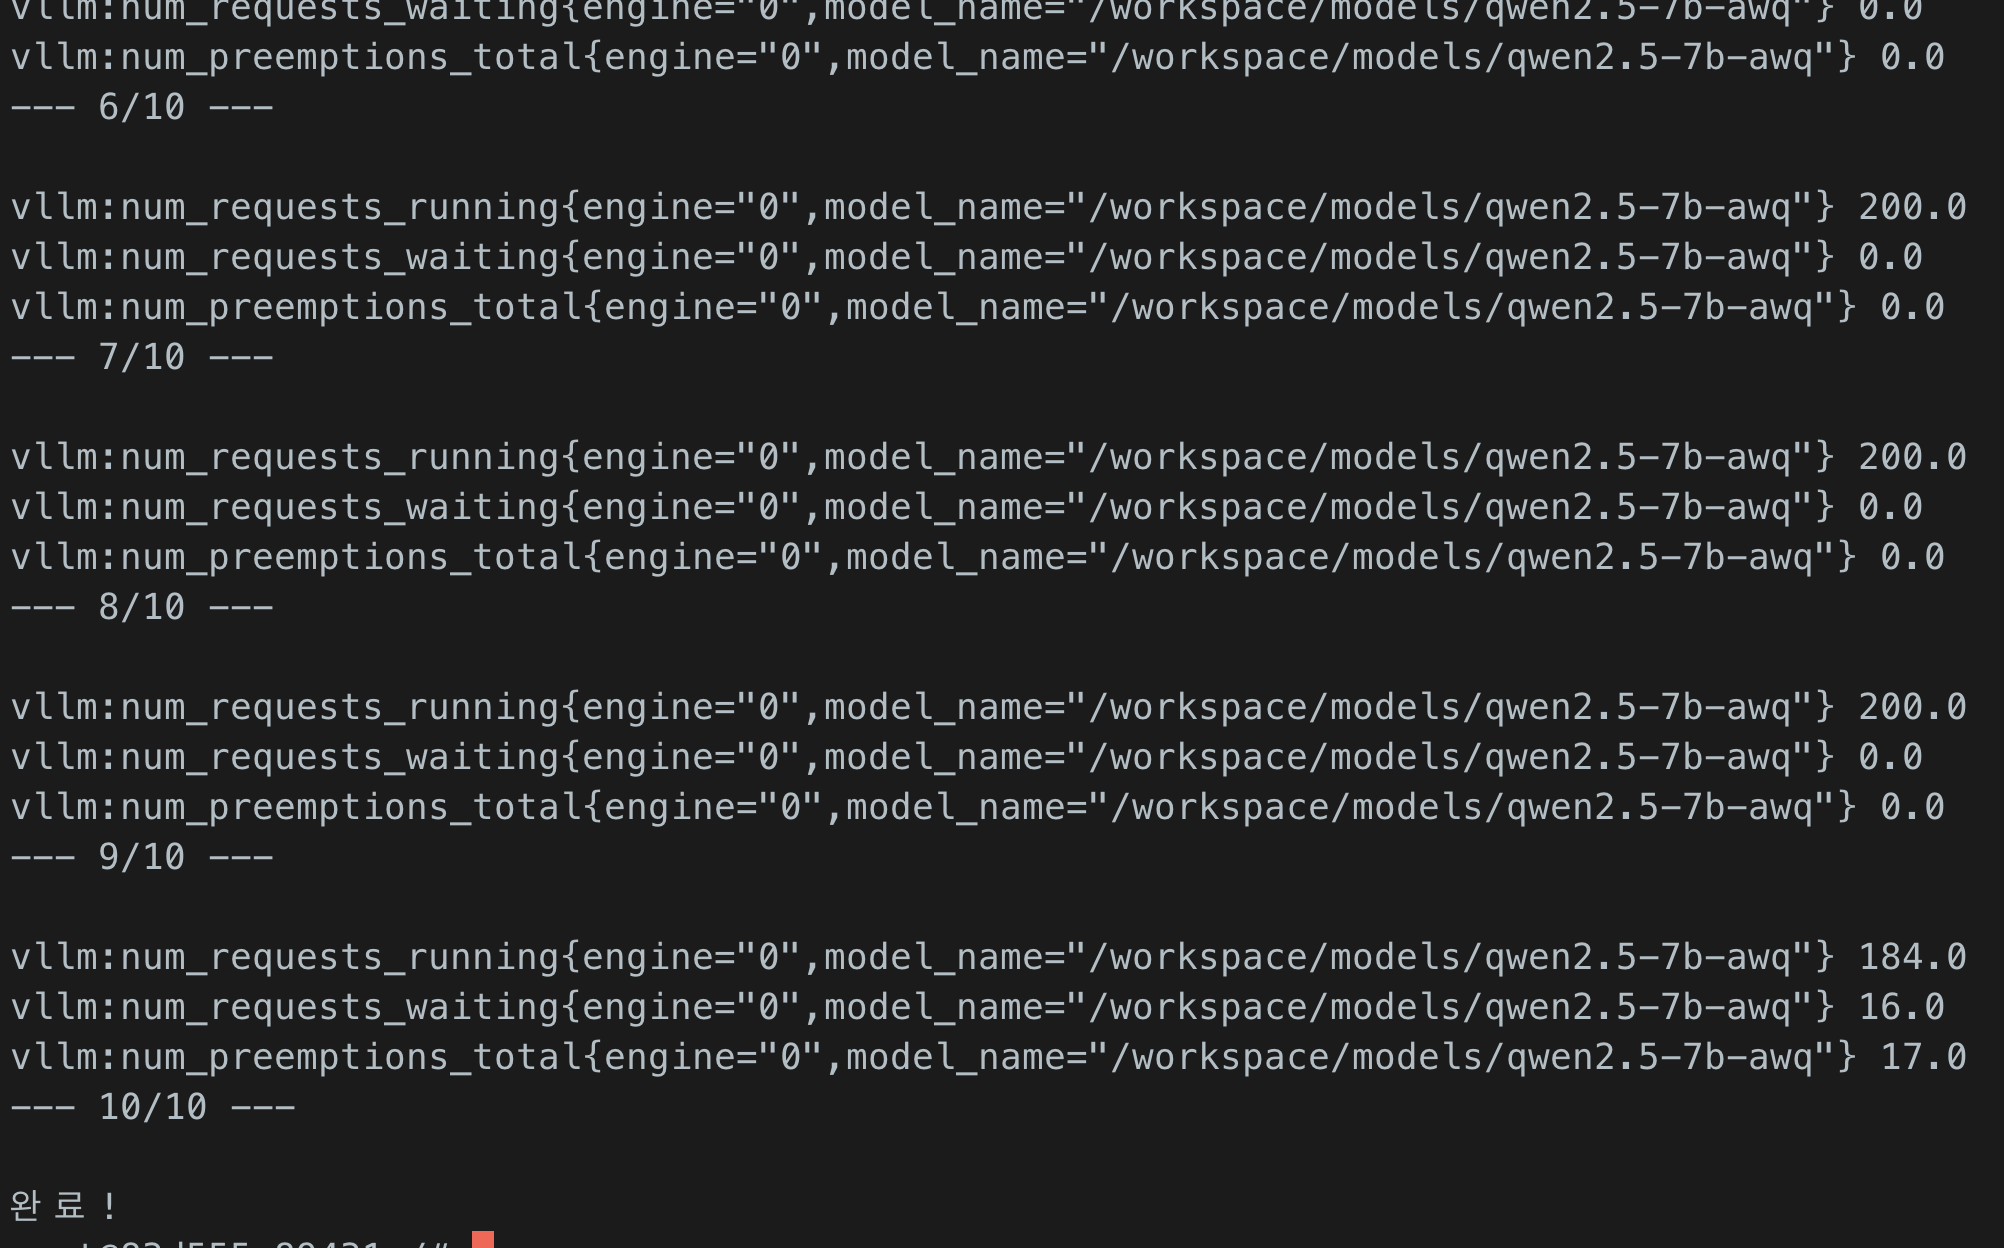 ▲ vLLM /metrics 엔드포인트 결과. waiting=16, preemption=17로 KV Cache 부족 상황 확인
4.4 운영 관점에서의 시사점
이 메트릭을 Prometheus로 수집하고 Grafana 대시보드에 올리면, num_requests_waiting이 임계값을 넘을 때 K8s HPA로 GPU Pod를 추가하는 오토스케일링 전략을 구현할 수 있다. num_preemptions가 지속적으로 발생한다면 GPU 메모리가 부족하다는 신호이므로, 양자화 적용이나 GPU 업그레이드를 고려해야 한다.
5. QLoRA 학습 파이프라인: 데이터 수집부터 LoRA 서빙까지
5.1 왜 학습 파이프라인까지?
LLM 서빙만 하면 절반이다. 실제 LLMOps 플랫폼은 학습 → 평가 → 저장 → 배포의 전체 사이클을 지원해야 한다. QLoRA로 전체 5단계를 직접 구현해봤다.
5.2 전체 파이프라인
1
2
3
4
5
6
7
8
9
10
Stage 1: 데이터 수집/전처리
  ↓ train/validation 분할, 프롬프트 템플릿 적용
Stage 2: QLoRA 학습
  ↓ 4bit 양자화 + LoRA (r=16, alpha=16)
Stage 3: 평가
  ↓ Eval Loss 측정
Stage 4: 모델 레지스트리 등록
  ↓ LoRA Adapter 저장 + 버전 메타데이터
Stage 5: 배포
  ↓ vLLM --enable-lora로 서빙
5.3 Stage 1: 데이터 수집 및 전처리
장애 분석용 학습 데이터를 구성했다. 프로덕션에서는 수천~수만 건이 필요하지만, 파이프라인 검증 목적으로 6건을 사용했다.
1
2
3
4
5
6
7
raw_data = [
    {"instruction": "다음 에러 로그를 분석해주세요: OOMKilled Pod nginx-7b4f5",
     "output": "원인: Pod 메모리 Limit 초과. 해결: resources.limits.memory를 증가"},
    # ... 총 6건
]
train_data = raw_data[:4]  # 4건
val_data = raw_data[4:]    # 2건
5.4 Stage 2: QLoRA 학습
1
2
3
4
5
6
7
8
9
10
11
12
13
14
# 4bit 양자화 설정
bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.float16,
)

# LoRA 설정
lora_config = LoraConfig(
    r=16, lora_alpha=16,
    target_modules=["q_proj", "v_proj"],
    lora_dropout=0.05,
    task_type="CAUSAL_LM",
)
| 메트릭 | 값 |
|---|---|
| 4bit 모델 GPU 메모리 | 5.9GB |
| 전체 파라미터 | 7,620,662,784 |
| 학습 파라미터 | 5,046,272 (0.066%) |
| 학습 소요시간 (3 steps) | 2.7초 |
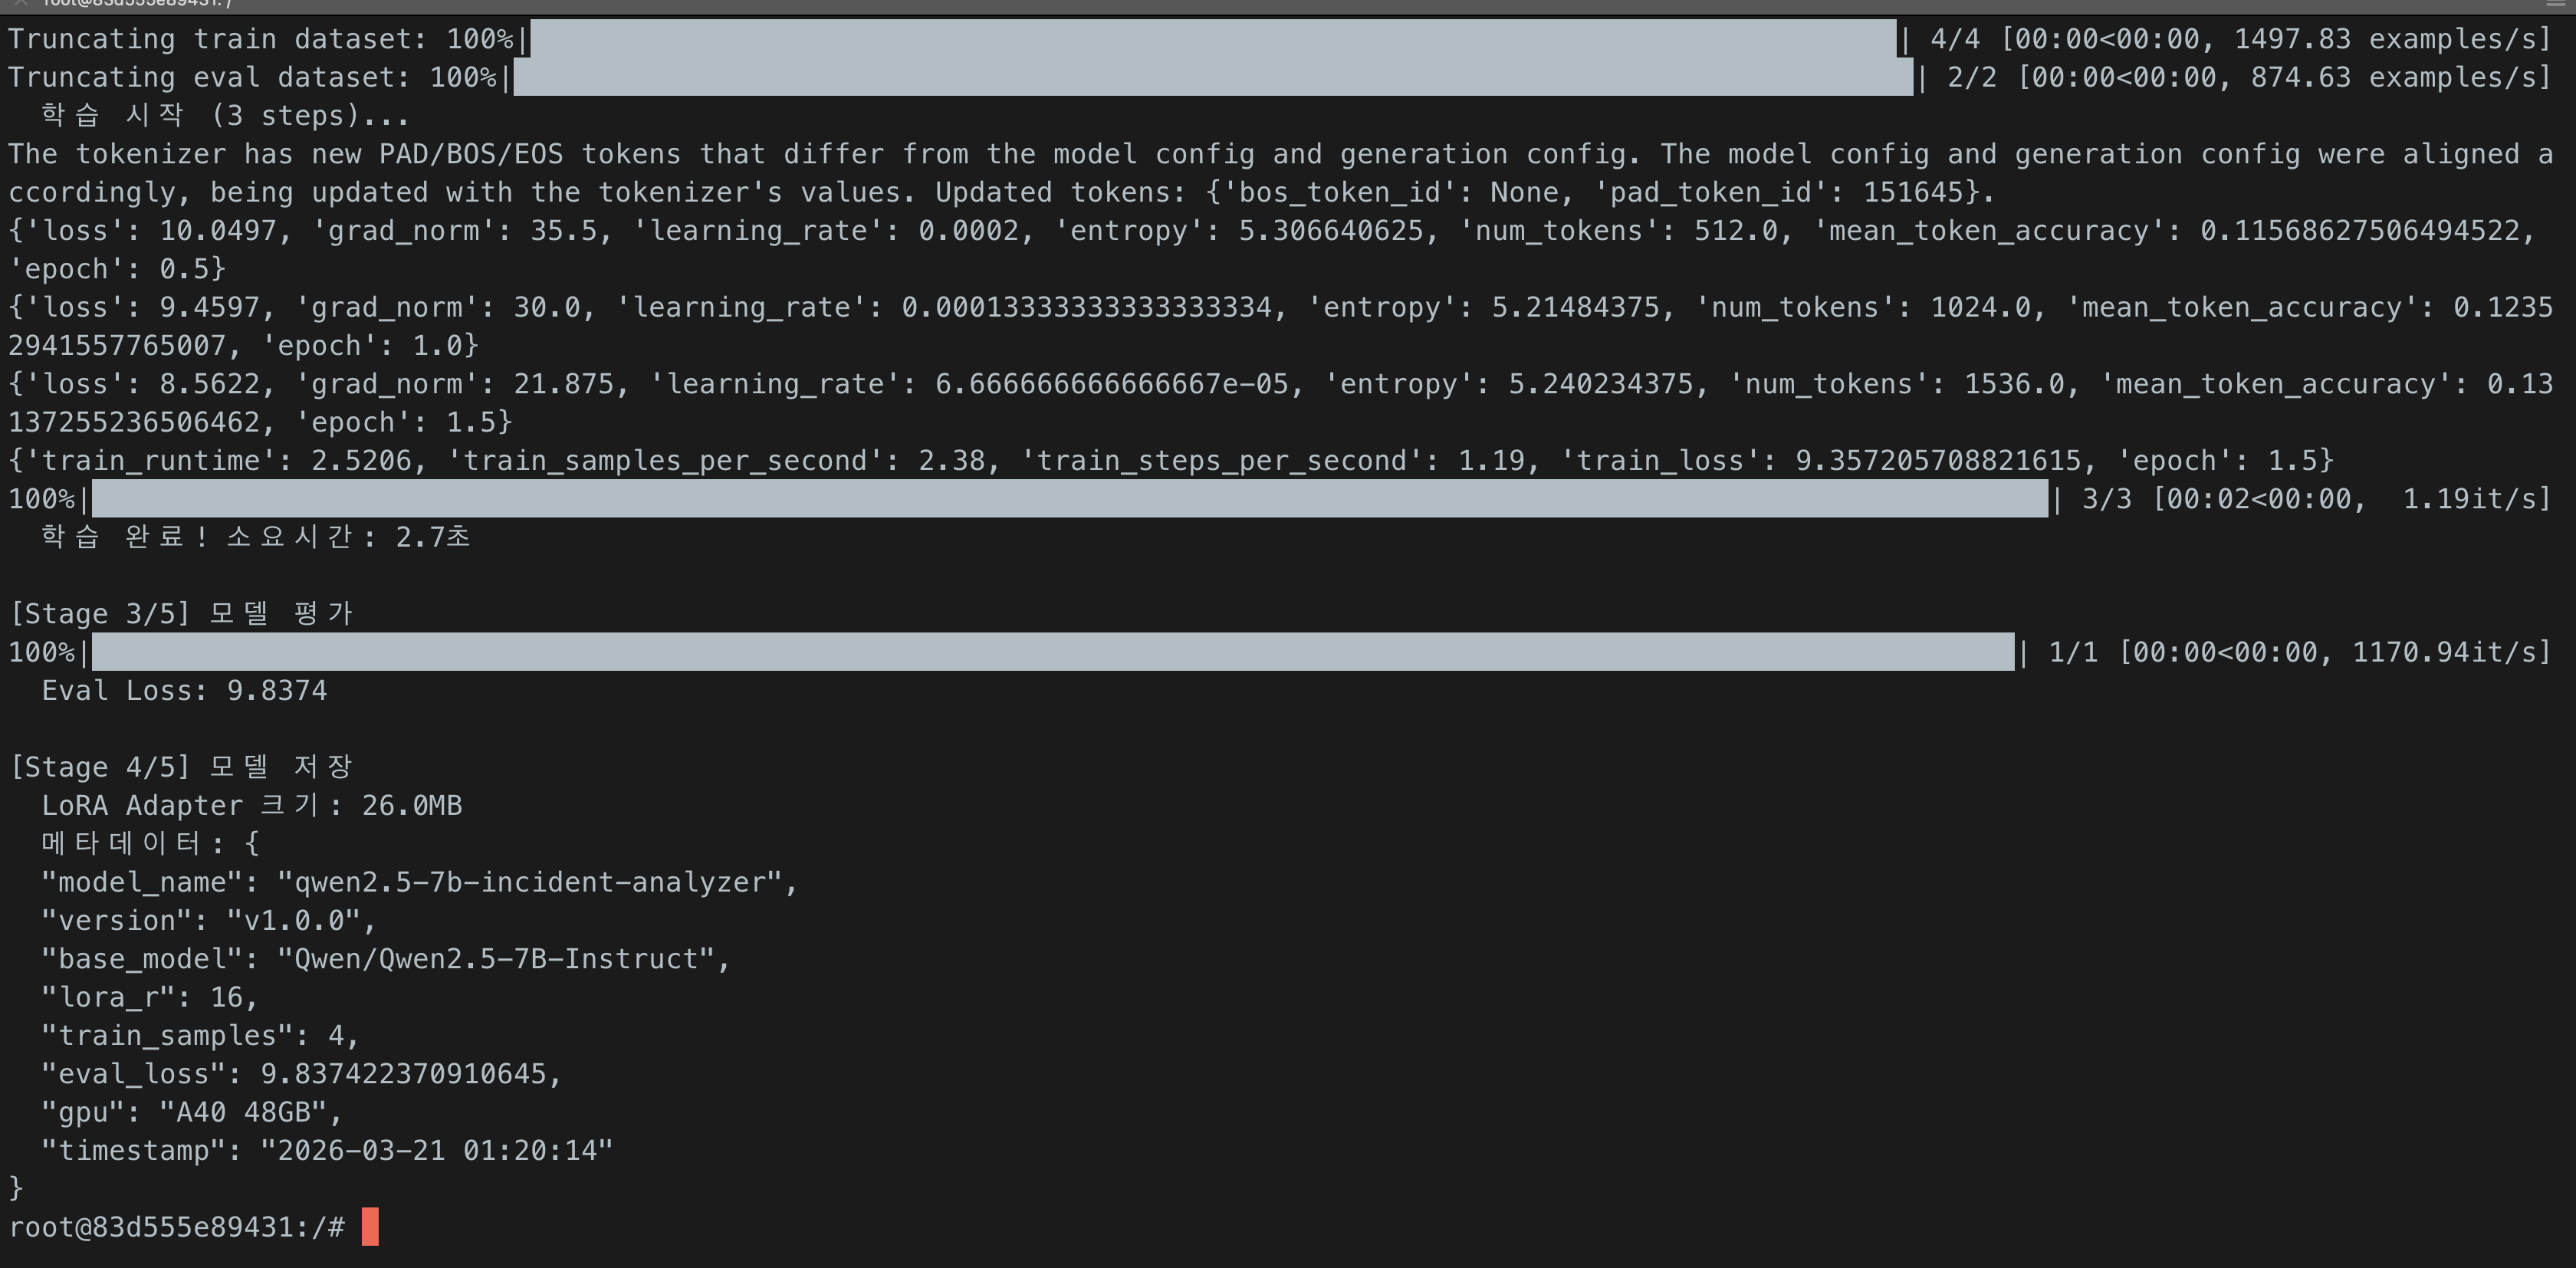 ▲ QLoRA 학습 로그. Loss가 10.05 → 9.46 → 8.56으로 감소하며 학습이 정상 진행됨을 확인
전체 파라미터의 0.066%만 학습한다. 7B 모델을 Full Fine-tuning하려면 A100 80GB가 필요하지만, QLoRA는 5.9GB만 사용하므로 A40 한 장으로 충분하다.
5.5 Stage 3: 평가
1
Eval Loss: 9.8374
학습 데이터 4건, 3 step만 돌렸으므로 Loss가 높은 건 당연하다. Loss가 10.05 → 9.46 → 8.56으로 감소 추세를 보이므로 학습 자체는 정상적으로 진행된 것이다. 프로덕션에서는 수천 건의 데이터로 수백 step 학습하면 Loss가 크게 낮아진다.
5.6 Stage 4: 모델 레지스트리 등록
1
2
3
4
5
6
7
8
9
10
11
model.save_pretrained(save_path)  # LoRA Adapter만 저장

metadata = {
    "model_name": "qwen2.5-7b-incident-analyzer",
    "version": "v1.0.0",
    "base_model": "Qwen/Qwen2.5-7B-Instruct",
    "lora_r": 16,
    "eval_loss": 9.8374,
    "gpu": "A40 48GB",
    "timestamp": "2026-03-21 01:20:14"
}
LoRA Adapter 크기: 26.0MB — 전체 모델 14GB 대비 0.18%. 배포 시 14GB 모델을 다시 올리는 게 아니라 26MB 어댑터만 교체하면 되므로 롤백이 초 단위로 가능하다.
5.7 Stage 5: vLLM LoRA 서빙
1
2
3
4
5
python -m vllm.entrypoints.openai.api_server \
  --model Qwen/Qwen2.5-7B-Instruct \
  --enable-lora \
  --lora-modules incident-analyzer=/workspace/qlora_output/final_adapter \
  --max-lora-rank 16
1
2
3
4
5
6
7
8
# 모델 목록 확인 — base + LoRA 모두 서빙
curl http://localhost:8000/v1/models
# → base model + incident-analyzer 두 개 노출

# LoRA 모델로 요청
curl http://localhost:8000/v1/chat/completions \
  -d '{"model": "incident-analyzer",
       "messages": [{"role": "user", "content": "OOMKilled Pod nginx-7b4f5 분석해주세요"}]}'
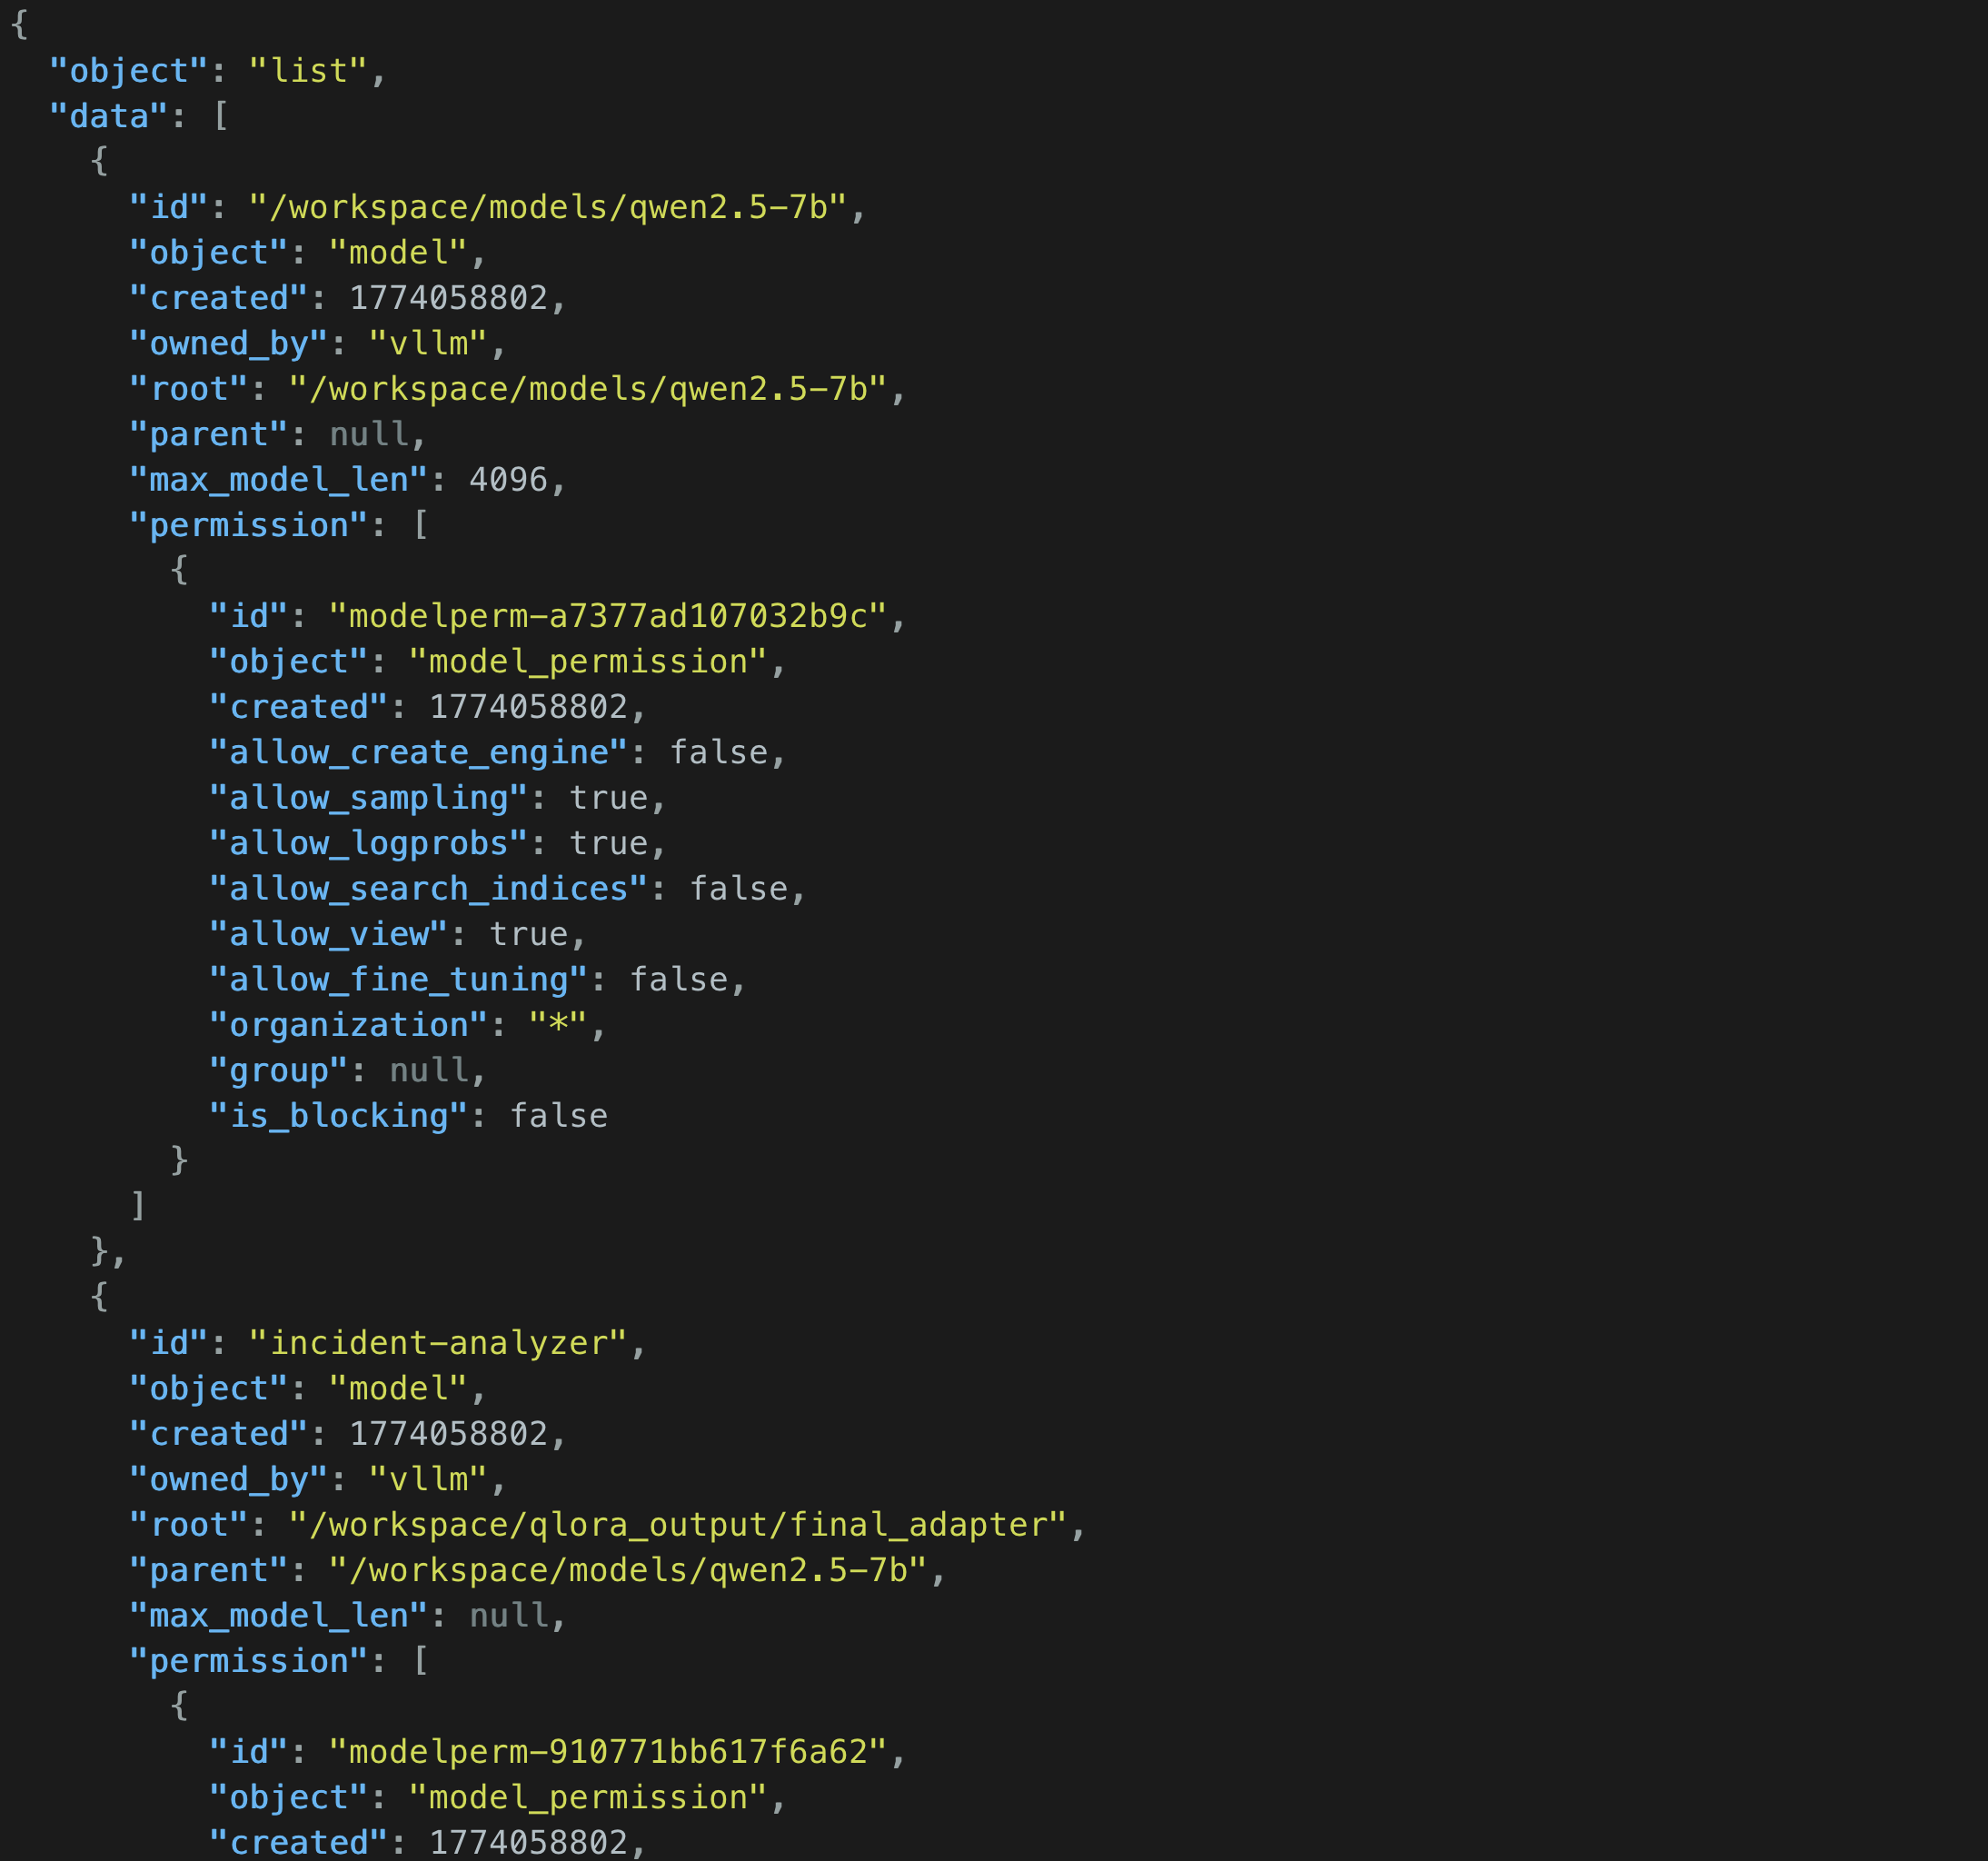 ▲ /v1/models API 응답. base model과 incident-analyzer LoRA 모델이 동시에 서빙되는 것을 확인
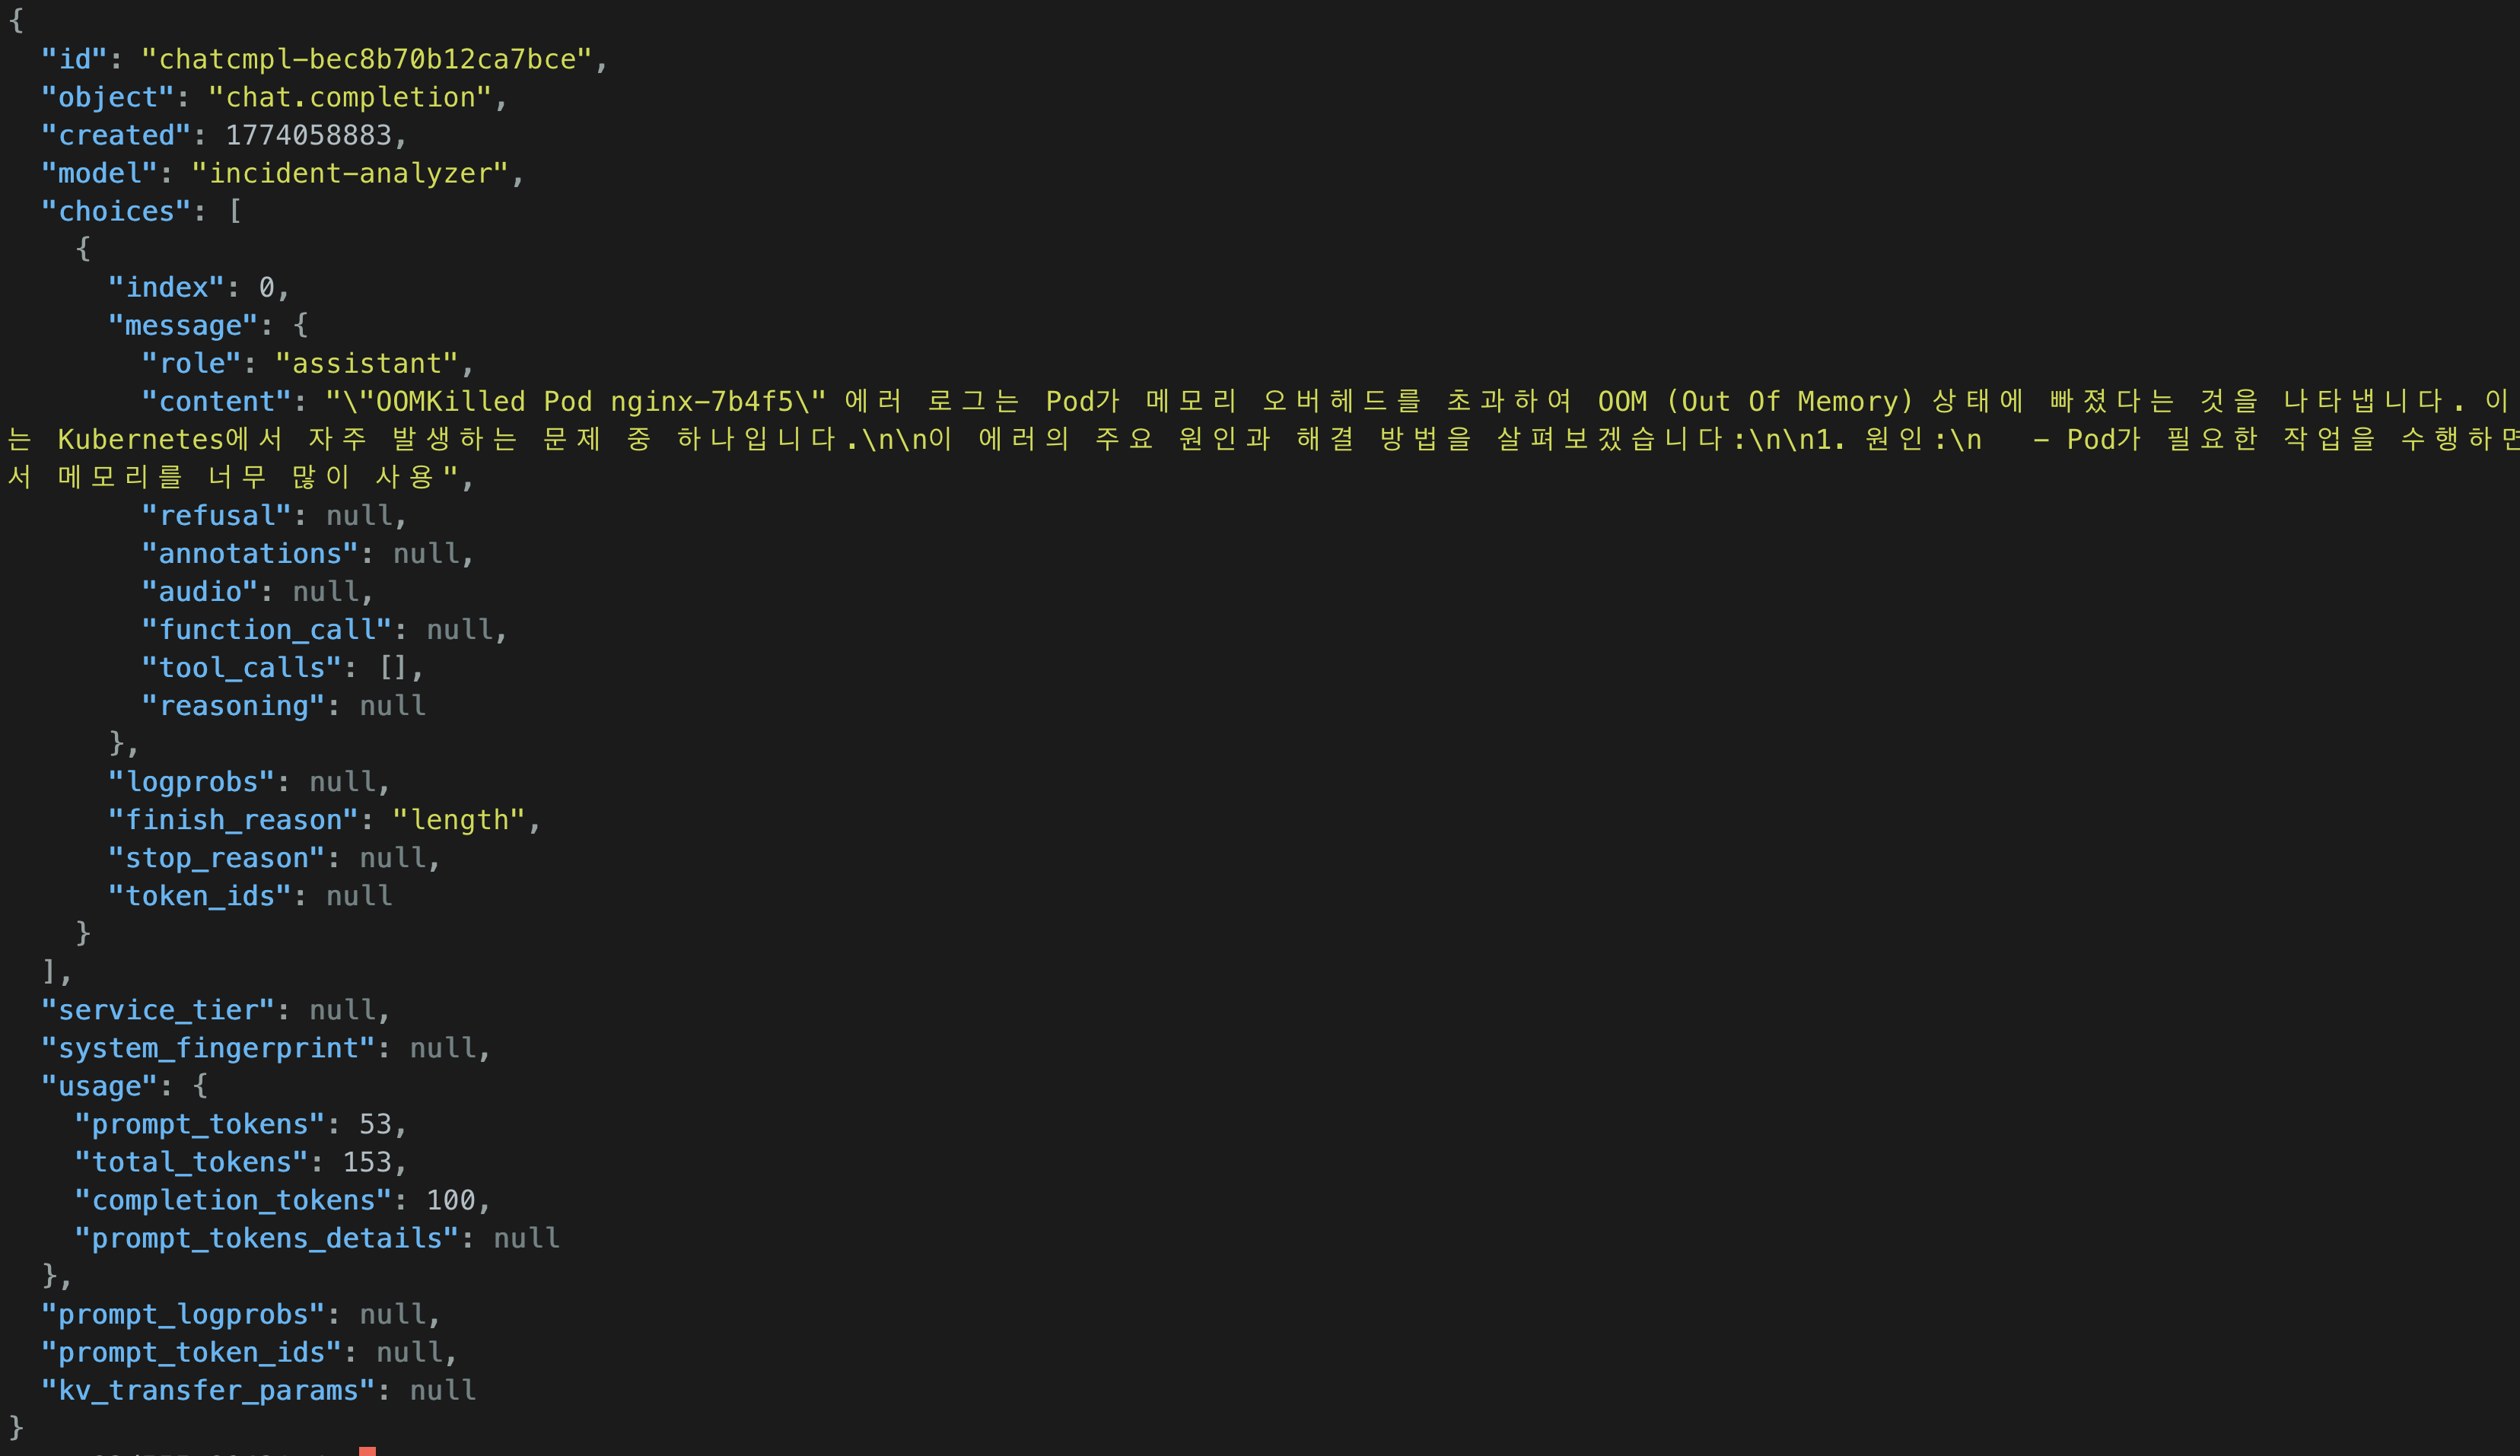 ▲ incident-analyzer LoRA 모델의 실제 응답. OOMKilled 장애 분석 요청에 대한 추론 결과
하나의 base model 위에 여러 LoRA adapter를 동시에 서빙할 수 있다. 멀티 테넌트 환경에서 고객별로 Fine-tuning된 모델을 26MB adapter만 교체하며 서빙할 수 있다는 뜻이다.
6. 마무리: LLM 서빙은 트레이드오프의 연속이다
전체 벤치마크 결과 요약
| 테스트 | 핵심 결과 |
|---|---|
| FP16 단일 요청 | TTFT 57ms, TPS 35.4 |
| AWQ 단일 요청 | TTFT 99ms, TPS 15.2 |
| Continuous Batching (50명) | RPS 6.7, P99 7,420ms |
| Static Batching (50명) | RPS 1.1, P99 47,091ms |
| KV Cache 제한 (200명) | waiting 16, preemption 17 |
| QLoRA 학습 | Adapter 26MB (0.18%), 5.9GB GPU |
핵심 정리
| 개념 | 기억할 포인트 |
|---|---|
| 양자화 | “무조건 빠르다”가 아니라 메모리 최적화. VRAM 충분하면 FP16이 더 빠름 |
| Continuous Batching | 동시 50명에서 throughput 6배, P99 84% 감소 |
| PagedAttention | KV Cache를 페이지 단위로 동적 할당하여 메모리 낭비 60~70% 감소 |
| Preemption | KV Cache 부족 시 기존 요청을 swap — 모니터링 필수 |
| QLoRA | 전체 파라미터의 0.066%만 학습, Adapter 26MB |
| LoRA 서빙 | base model 1개 + adapter N개로 멀티 테넌트 가능 |
LLM 서빙 설계 원칙
- GPU 메모리가 충분하면 FP16: 양자화는 메모리가 부족할 때만
- Continuous Batching은 필수: Static 대비 throughput 6배
- num_requests_waiting 모니터링: 이 값이 오토스케일링 트리거
- LoRA로 멀티 테넌트: 14GB 모델 재배포 대신 26MB adapter 교체
- “왜 이 설정인지” 설명할 수 있는 파라미터만 쓰자
인덱스가 공짜가 아니듯, GPU 메모리도 공짜가 아니다. 모든 선택에는 트레이드오프가 존재하고, 그 트레이드오프를 수치로 증명할 수 있어야 한다.
다음 장: Multi-Agent 시스템에서의 LLM 서빙 최적화
vLLM으로 모델을 서빙하는 건 알겠다. 그런데 여러 Agent가 동시에 LLM을 호출하면?
- Agent별 토큰 사용량과 비용을 어떻게 추적할까?
- 간단한 분석은 7B, 복잡한 분석은 70B로 라우팅하면?
- Langfuse로 전체 파이프라인을 어떻게 모니터링할까?
다음 편에서 계속된다.
참고 자료
- 본문 벤치마크 스크립트 및 코드: riverfrot/vllm-benchmark-code
- vLLM GitHub: vllm-project/vllm
- PagedAttention 논문: Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention” (2023)
- Qwen2.5 모델: Qwen/Qwen2.5-7B-Instruct
- QLoRA 논문: Dettmers et al., “QLoRA: Efficient Finetuning of Quantized Language Models” (2023)
- LLM 추론에 대한 NVFP4의 영향: nvidia-blackwell