MySQL 아키텍처 및 상세 설명 2편 - 인덱스
들어가며
1
SELECT * FROM wallet WHERE user_id = 1;
지난 편에서는 “쿼리 한 줄이 실행될 때 MySQL 내부에서 벌어지는 일”을 전체 아키텍처 관점에서 살펴봤다. 우리는 데이터가 디스크에서 메모리(Buffer Pool)로 올라오고, Executor가 그것을 퍼올리는 과정을 확인했다.
하지만 여전히 풀리지 않은 의문이 있다. “똑같은 SELECT 문인데, 왜 어떤 건 0.01초 만에 나오고, 어떤 건 10초나 걸릴까?”
이 질문에 답하려면 인덱스(Index)의 실체를 파헤쳐야 한다. 단순히 “책의 목차” 정도로만 알고 있었다면, 오늘은 그 내부인 B+Tree와, 어떤 방식으로 검색 비용을 최적화 하는지에 대해 옵티마이저를 살펴보자.
특히 “PK가 없어도 내부는 B+Tree라는데, 왜 전체를 다 뒤져야(Full Scan) 하는가?”에 대해서 확인 한후 추후 실제 데이터 흐름 과 성능 개선을 위해 인덱스 튜닝은 어떤 방식을 추천하는지 알아보도록 하자
목차
- Mysql Index Using Component와 Disk까지의 데이터흐름
- 인덱스의 자료구조: 왜 하필 B+Tree인가?
- Clustered vs Secondary Index
- 핵심 질문: 암묵적 PK가 있는데 왜 느릴까?
- 옵티마이저의 선택 기준: Cost와 튜닝
- 5.1 복합 인덱스와 Leftmost Prefix
- 5.2 ESR Rule
- 5.3 Covering Index
- 마무리: 인덱스는 공짜가 아니다
1. Mysql Index Using Component와 Disk까지의 데이터흐름
1.1 MySQL Index Component 아키텍처 다이어그램
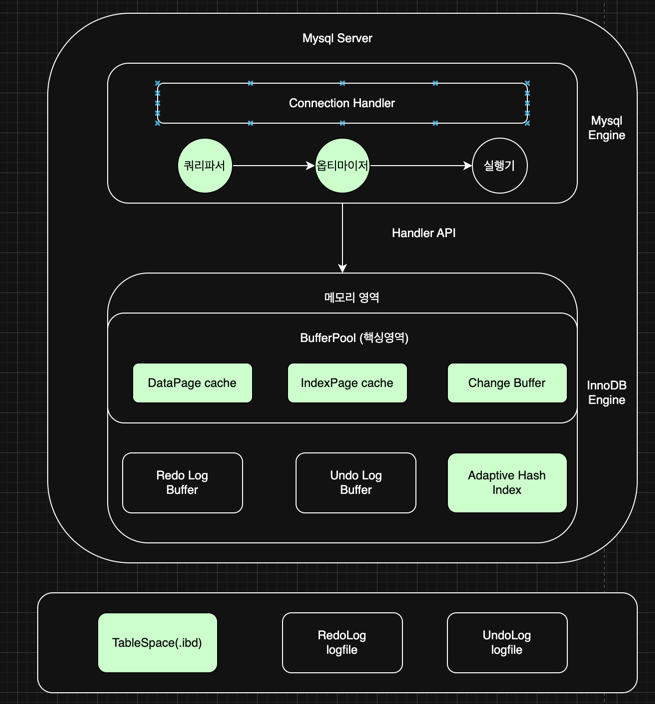
위 그림은 이전에 작성한 mysql 전체 아키텍쳐에 대한 그림을 약간 수정하여 가져왔다 이 그림을 기반으로 설명을 진행해 나갈텐데 여기서 특히 중요한 컴포넌트는 옵티마이저 와 실제 인덱스가 저장되는 TableSpace 영역이다 물론 BufferPool도 중요하지만 이번에 주로 설명 할 쿼리를 어떻게 최적화 하는지와 이러한 실제 데이터를 어떤 자료구조(B+Tree)로 저장하는지 알아야 추후 서술할 API 성능 향상을 위한 Index튜닝을 진행 할 수 있기 때문이다.
핵심 포인트: 옵티마이저가 쿼리 실행 계획을 결정하고, TableSpace의 B+Tree 구조가 데이터를 저장하는 방식을 이해해야 효과적인 인덱스 튜닝이 가능하다.
2. 인덱스의 자료구조: 왜 하필 B+Tree인가?
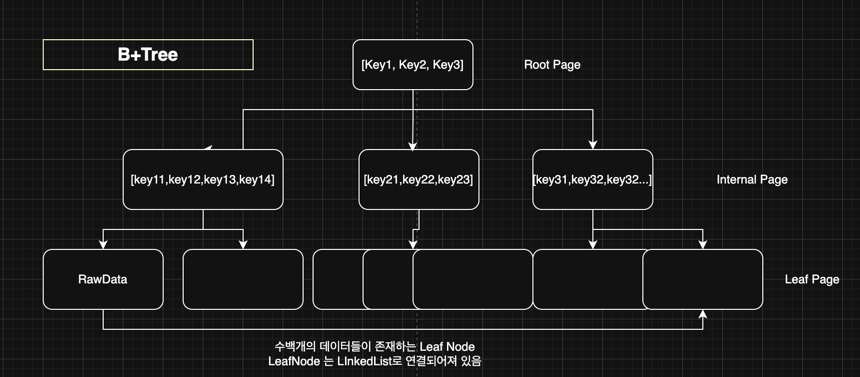
2.1 높이(Height)의 개념 - 이진트리, B-Tree가 사용 안되는 이유 ⭐
한줄 요약 : 이진 트리와 B-Tree 모두 노드의 높이가 높아 디스크 I/O가 많이 발생한다.
왜 높이가 중요한가?
InnoDB는 데이터를 읽을 때 16KB 페이지 단위로 디스크에서 가져온다. 트리의 높이가 곧 디스크 I/O 횟수이므로, 높이가 높을수록 데이터를 찾는 데 오래 걸린다.
이진 트리의 한계
이진 트리는 자식 노드를 최대 2개만 가질 수 있다. 200만 개의 데이터가 있다면 트리의 높이가 약 21단계(log₂ 2,000,000 ≈ 21)까지 깊어진다. 즉, 데이터 하나를 찾는 데 최대 21번의 디스크 I/O가 필요하다.
B-Tree의 개선과 한계
B-Tree는 한 노드에 여러 개의 키를 담아 높이를 낮췄다. 하지만 B-Tree는 Root/Internal 노드에도 실제 데이터(Row 전체)를 저장한다. 노드 하나의 크기가 16KB로 한정되어 있으므로, 데이터가 크면 한 노드에 담을 수 있는 키 수가 줄어들고 결국 높이가 다시 높아진다.
B+Tree의 해결책
B+Tree는 Root/Internal 노드에는 키(PK)만 저장하고, 실제 데이터는 Leaf 노드에만 저장한다. 이를 통해 상위 노드에 훨씬 많은 키를 담을 수 있고, 트리의 높이를 3~4단계로 유지할 수 있다. 이 구조를 이해해야 왜 PK를 작게 설계해야 하는지, 불필요한 인덱스가 어떻게 성능 저하를 일으키는지 알 수 있다.
위 내용을 이해하면 아래의 흐름에 대해 알 수 있다 결국 이번장의 목표는 어떻게 하면 위 구조를 잘 이해하여 인덱스를 설계하는지에 달려 있다
PK가 크면 → 한 노드에 담을 수 있는 키 수 감소 → Fan-out 감소 → 트리 높이 증가 → 디스크 I/O 증가
2.2 Adaptive Hash Index (AHI)
한줄 요약 : 자주 조회되는 동일 키를 해시맵에 캐싱하여 B+Tree 탐색 없이 O(1)로 접근하는 InnoDB 내부 최적화 기법
InnoDB에 존재하는 두번째 자료구조는 Adaptive Hash Index이다 말 그대로 메모리상에 해시맵을 구축 하여 자주 사용하는 데이터들에 한해 특정 키에 대한 정보를 저장하는 역할을 한다
이를 통해 사용자는 자주 사용하는 쿼리 즉 동일 조건으로 들어오는 쿼리에 대해서는 지난 응답보다 더 빠르게 응답을 받게 된다
그렇다면 AHI가 만능인걸까?
아쉽게도 그렇지는 않다. 동일 키 반복 조회 일때는 효과적이나 범위 검색 위주인 경우에는 해시키를 지정 할 수 없어 AHI를 사용 할 수 없고
자주 데이터가 추가되는경우 hash 값이 변경되어 효과적이지 않음
1
2
AHI 상태 확인 하는 sql 명령어
SHOW ENGINE INNODB STATUS;
3. Clustered vs Secondary Index
한줄 요약 : Clustered Index는 PK 순서로 실제 데이터가 정렬 저장되고, Secondary Index는 리프에 PK만 저장하여 다시 Clustered Index를 탐색(Primary Key Lookup)해야 한다
Clustered Index
말 그대로 인덱스가 군집(Clusterd) 모여져 있다라는걸 뜻하며
인덱스 키 순서대로 데이터가 물리적으로 군집되어 저장되어 있는 모습을 보고 위와 같은 이름으로 명시되어졌다
주로 PK를 Clustered Index를 말하며 Secondary Index는 이러한 PK를 실제 데이터(Leaf Page)로 갖게 된다.
Secondary Index
Clustered Index가 아닌 PK를 제외한 나머지 인덱스를 뜻하며, 별개의 인덱스를 통해 검색 쿼리를 지정할때 사용 된다.
이때 실제 데이터는 Clustered Index에 존재하며 Secondary Index의 LeafPage에는 PK와 Secondary Index의 값이 저장이 된다.
구조 비교
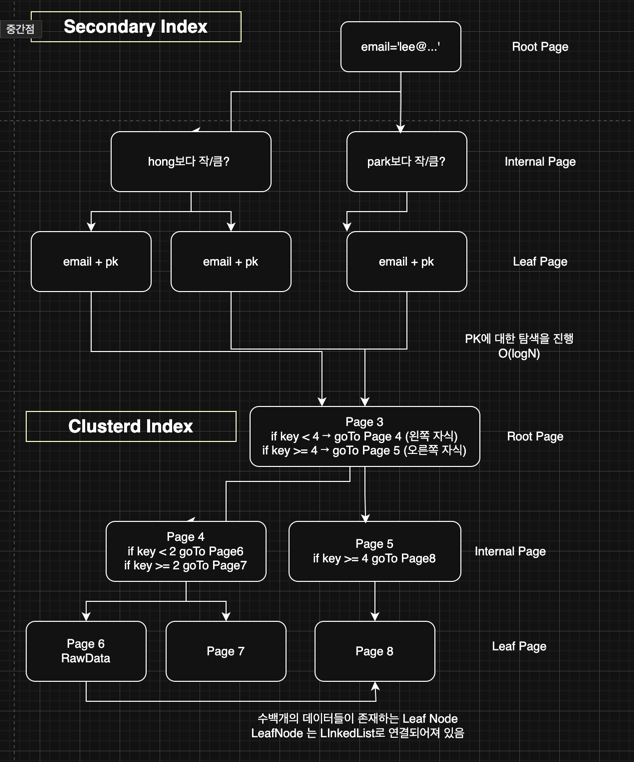 해당 내용에 대해 좀 더 쉽고 내부구조를 파악하고자 위와 같은 사진을 준비 하였다 위 예시 데이터는 id를 PK로 구성하고 email을 Secondary-Index로 구성한 단순한 테이블이다.
이를 테이블 생성쿼리로 만들면 아래와 같다 추후 아래 테이블은 옵티마이저 설명 까지 사용하게 될 예정입니다.
1
2
3
4
5
6
7
8
9
10
11
12
13
-- 테이블 생성
CREATE TABLE users (
    id         BIGINT       NOT NULL AUTO_INCREMENT,
    email      VARCHAR(255) NOT NULL,
    name       VARCHAR(100),
    age        INT,
    status     VARCHAR(20),   -- 'ACTIVE', 'INACTIVE'
    created_at DATETIME,
    PRIMARY KEY (id)
) ENGINE=InnoDB;

-- Secondary Index 생성 (email)
CREATE INDEX idx_email ON users (email);
위 구조에서 우리가 알 수 있는 것을 아래 표와 같이 정리 하였다.
ClusteredIndex 와 SecondaryIndex 차이
| 구분 | Clustered Index | Secondary Index |
|---|---|---|
| 개수 | 테이블당 단 1개 | 여러 개 가능 |
| 리프 노드 | Row 전체 데이터 | PK 값만 |
| 물리적 정렬 | PK 순서 = 저장 순서 | 별도 정렬 |
| 데이터 접근 | 직접 접근 | PK로 다시 Clustered Index 탐색 |
실제 데이터 흐름 (실제 쿼리 질의 실행흐름)
1
SELECT * from user where email="lee@naver.com"
실행 과정:
- email 인덱스 B+Tree 탐색 → PK=1 발견
- PK=1로 Clustered Index 탐색 → 실제 Row 획득 ↑ 이게 추가 비용! (Primary Key Lookup)
이래서 PK가 크면 Secondary Index도 뚱뚱해진다. Secondary Index 리프에 PK 전체가 복사되기 때문이다.
1
2
3
4
5
6
7
PK 크기 비교:
─────────────────────────────────────────
BIGINT AUTO_INCREMENT    →  8 bytes
email + name + created_at      → 8 + 36 + 100+ bytes = 150+ bytes

Secondary Index 3개 만들면?
→ 150바이트 × 3 = 450바이트가 row마다 추가 저장
4. 핵심 질문: 암묵적 PK가 있는데 왜 느릴까?
한줄 요약 : 암묵적으로 생성된 Row ID는 개발자가 접근할 수 없어서 옵티마이저가 인덱스를 활용하지 못하고 Full Table Scan을 수행한다
“테이블 만들 때 PK 안 정하면 InnoDB가 알아서 만든다던데(Gen_Clust_Index), 그럼 내부적으로 B+Tree니까 빨라야 하는 거 아니에요?”
MySQL에 대해서 공부할때 위와 같은 질문이 생길수도 있다
하지만 결론부터 이야기 하자면 전체 스캔(Full Table Scan)을 한다.
그 이유는 암묵적 PK가 어떤 방식으로 생기는지를 보면 이해 할 수있는데
암묵적 PK 생성되는 방법
PK를 명시하지 않으면 InnoDB는 다음 순서로 대체 수단을 찾는다:
NOT NULL + UNIQUE컬럼 → PK로 승격- 그것도 없으면 → 내부 6바이트 Row ID 자동 생성
이러한 값이 있으면 개발자가 어떤 컬럼으로 질의하게 되더라도 옵티마이저 입장엣서는 해당 인덱스를 찾을 수 없기 때문에 전체 테이블 스캔을 하게 된다.
5. 옵티마이저의 선택 기준: Cost와 튜닝
한줄 요약 : 옵티마이저는 예상 비용(Cost)을 계산하여 가장 저렴한 실행 계획을 선택한다
옵티마이저의 종류는 여러가지가 있으나 현재 대부분의 DBMS에서는 비용기반최적화(CBO), 예전 오라클에서 자주사용하던(RBO)가 존재한다
이번장에서는 비용기반최적화에 대해 자세히 알아보도록 하자
옵티마이저가 선택하는 최소한의 기준
만약 전체 데이터의 20% 이상을 가져와야 한다면, 옵티마이저는 인덱스를 포기하고 Full Scan을 선택한다.
이유는 Random I/O vs Sequential I/O 비용 차이 때문이다.
1
2
3
4
5
6
7
인덱스 사용 시:
Secondary Index → PK 획득 → Clustered Index → 데이터
                  ↑ 매번 다른 페이지로 점프 (Random I/O)

Full Scan 시:
페이지 1 → 페이지 2 → 페이지 3 → ...
         ↑ 순차적으로 쭉 읽기 (Sequential I/O)
만약 이렇게 Random I/O가 지속적으로 발생한다면 옵티마이저는 인덱스를 포기하고 전체 테이블을 Sequential I/O로 Full Scan하게 된다.
5.1 복합 인덱스와 Leftmost Prefix
한줄 요약 : 복합 인덱스는 선언 순서대로 정렬되므로 왼쪽 컬럼부터 조건에 포함해야 인덱스를 활용할 수 있다
복합 인덱스 (Composite Index)
1
CREATE INDEX idx_name_age ON users (name, age);
이 인덱스는 name을 먼저 정렬하고, 같은 name 내에서 age로 다시 정렬한다.
1
2
3
4
5
6
인덱스 저장 순서:
| name='김' | age=20 |
| name='김' | age=30 |
| name='김' | age=40 |
| name='이' | age=25 |
| name='이' | age=35 |
Leftmost Prefix Rule
1
2
3
4
5
6
-- 인덱스 사용 O
SELECT * FROM users WHERE name = '김';
SELECT * FROM users WHERE name = '김' AND age = 30;

-- 인덱스 사용 X
SELECT * FROM users WHERE age = 30;  -- name 없이 age만!
왜? 전화번호부 비유로 생각하면 쉽다. (성, 이름) 순으로 정렬된 전화번호부에서 “이름이 ‘철수’인 사람”만 찾으려면? 처음부터 끝까지 다 뒤져야 한다.
카디널리티(Cardinality) 고려
카디널리티 = 컬럼의 고유값 개수. 높을수록 선택도가 좋다.
1
2
3
4
5
6
7
8
-- 비효율적: 카디널리티 낮은 컬럼이 앞에
CREATE INDEX idx_bad ON users (status, email);
-- status: 'ACTIVE', 'INACTIVE' 2개 → 카디널리티 낮음
-- email: 거의 유니크 → 카디널리티 높음

-- 효율적: 카디널리티 높은 컬럼이 앞에
-- 이유 : 가장 카디널리티가 높은 순서대로 정렬되어 데이터베이스에 저장됨
CREATE INDEX idx_good ON users (email, status);
5.2 ESR Rule ⭐
한줄 요약 : 복합 인덱스 설계 시 Equal → Sort → Range 순서로 배치하며, Range 조건 이후 컬럼은 인덱스를 활용하지 못한다
Equal → Sort → Range 순서로 컬럼을 배치 해야 한다.
복합 인덱스 설계의 핵심이다.
1
2
3
4
5
-- 쿼리
SELECT * FROM users
WHERE status = 'ACTIVE'           -- Equal (=)
  AND created_at > '2024-01-01'   -- Range (>)
ORDER BY name ASC;                -- Sort (ORDER BY)
1
2
3
-- ESR 순서로 인덱스 설계
CREATE INDEX idx_esr ON users (status, name, created_at);
--                             Equal   Sort  Range
왜 이 순서인가?
1
2
3
1. Equal(=): 정확히 일치하는 지점으로 바로 이동
2. Sort: 이미 정렬되어 있으니 추가 정렬 불필요
3. Range: 범위 조건은 그 이후 컬럼의 인덱스 활용을 막음
Range가 마지막인 이유가 중요하다. 범위 조건 이후의 컬럼은 인덱스를 활용하지 못한다.
1
2
3
4
-- 인덱스: (status, name, created_at)

WHERE status = 'ACTIVE' AND name > '김' AND created_at = '2024-01-01'
      ↑ 사용              ↑ 사용         ↑ 사용 불가! (name이 범위라서)
5.3 Covering Index ⭐
한줄 요약 : SELECT하는 모든 컬럼이 인덱스에 포함되면 Clustered Index 탐색 없이 인덱스만으로 쿼리가 완료된다 (Using index)
SELECT하는 컬럼이 인덱스에 다 포함되어 있으면, Clustered Index까지 안 가도 된다.
1
2
3
4
5
-- 인덱스: (status, name)
CREATE INDEX idx_status_name ON users (status, name);

-- 쿼리
SELECT status, name FROM users WHERE status = 'ACTIVE';
1
2
3
4
5
일반 조회:
Secondary Index → PK 획득 → Clustered Index → 데이터

Covering Index:
Secondary Index → 여기서 끝! (status, name 다 있음)
EXPLAIN에서 Extra: Using index라고 표시되면 Covering Index가 적용된 것이다.
1
2
EXPLAIN SELECT status, name FROM users WHERE status = 'ACTIVE';
-- Extra: Using index ← 이거!
성능 향상의 치트키다. 특히 자주 조회하는 컬럼 조합이 있다면 해당 컬럼을 인덱스에 포함시키는 걸 고려해보자.
6. 마무리: 인덱스는 공짜가 아니다
인덱스 또한 항상 좋은것이 아니다. 특정 상황에 맞게 효율적으로 동작하는 치트키 같은 개념이고
이를 남용하는것은 의도에 맞지않게 성능 저하를 발생 시킬수 있다.
인덱스의 비용
| 작업 | 인덱스 없을 때 | 인덱스 있을 때 |
|---|---|---|
| SELECT | 느림 (Full Scan) | 빠름 |
| INSERT | 빠름 | 느림 (인덱스 갱신) |
| UPDATE | 빠름 | 느림 (인덱스 갱신) |
| DELETE | 빠름 | 느림 (인덱스 갱신) |
만약 인덱스가 3개라면? INSERT할 때 B+Tree를 3번 갱신해야 한다. 페이지 분할이 발생하면 더 느려진다.
핵심 정리
| 개념 | 기억할 포인트 |
|---|---|
| B+Tree | 높이를 낮춰서 디스크 I/O 최소화, 범위 검색 가능 |
| Clustered Index | 리프 노드 = 데이터, 테이블당 1개 |
| Secondary Index | 리프 노드 = PK, Clustered Index 다시 탐색 필요 |
| Covering Index | SELECT 컬럼이 인덱스에 다 있으면 초고속 |
| ESR Rule | Equal → Sort → Range 순서로 설계 |
인덱스 설계 원칙
- PK는 작고 순차적으로: AUTO_INCREMENT BIGINT 권장
- 자주 쓰는 WHERE 조건에만: 무분별한 인덱스는 독
- 복합 인덱스는 순서가 생명: Leftmost Prefix, ESR Rule
- Covering Index 고려: 자주 조회하는 컬럼 조합
“왜 필요한지” 설명할 수 있는 인덱스만 남기자.
다음 장 : MySQL에서의 Transaction
데이터를 빠르게 찾는 건 알겠다. 그런데 동시에 100명이 내 지갑 잔액을 수정하면 어떻게 될까?
- 돈 복사가 일어나지 않으려면?
- 서버가 죽어도 데이터가 안 날아가려면?
다음 편에서 다룰 내용:
- ACID: 트랜잭션의 4가지 원칙
- Isolation Level: 락(Lock)을 얼마나 걸지 눈치 싸움
- Deadlock: 동시에 키를 잡고 양보 하지 않는 상황
- 멱등성: 같은 요청을 두 번 보내도 항상 같은 결과를 얻게끔 생각하는것
[MySQL 3편] 트랜잭션: All or Nothing에서 계속된다.
참고 자료
- MySQL 8.0 Reference Manual - InnoDB Architecture
- 백은빈, 이성욱 - 『Real MySQL 8.0』 (위키북스)
- Baron Schwartz 외 - 『High Performance MySQL』 (O’Reilly)
- jeremycole innodb_diagram - https://github.com/jeremycole/innodb_diagrams/tree/main