[LLM Serving] TurboQuant란 무엇이며, 어떻게 KV Cache 양자화로 메모리를 5배 줄일 수 있을까?
들어가며
이전 글에서 우리는 vLLM 위에서 FP16 vs AWQ 벤치마크, Continuous Batching 성능, KV Cache 부족 시 Preemption까지 직접 확인했다. 그 과정에서 반복적으로 등장한 병목이 있었다.
1
2
3
4
KV Cache 크기 = 2 × layers × kv_heads × head_dim × seq_len × dtype_bytes

예시: Qwen2.5-7B (GQA: 28 attention heads, 4 kv heads), seq_len=4096, FP16
= 2 × 28 × 4 × 128 × 4096 × 2bytes ≈ 224MB (요청 1건)
GQA 덕분에 짧은 context에서는 KV Cache가 작지만, seq_len이 길어지면 선형 증가한다. 동시 50명 × 32K context만 되어도 KV Cache 총량이 ~90GB로 치솟는다. PagedAttention으로 할당 효율은 개선했지만, KV Cache 자체의 크기는 줄이지 못했다. AWQ로 모델 가중치를 줄여봤지만, 그건 KV Cache와는 별개의 문제였다.
2026년 3월, Google Research가 ICLR 2026에서 발표한 TurboQuant는 바로 이 KV Cache를 3~4bit으로 압축하는 기법이다. 이 글에서는 TurboQuant가 왜 필요한지 Transformer의 구조부터 짚어보고, 핵심 알고리즘을 분석한 뒤, 실제 벤치마크까지 수행한다.
목차
- TurboQuant 소개: 무엇을 해결하려는 기술인가
- KV Cache란 무엇인가, 왜 문제가 되는가
- 기존 해결 방향들: PagedAttention, AWQ, 그리고 한계
- TurboQuant 핵심 해결 방식 3가지
- 벤치마크: RunPod A40에서 KV Cache 양자화 실측
- 마무리 및 참고 링크
1. TurboQuant 소개: 무엇을 해결하려는 기술인가
1.1 한 줄 요약
TurboQuant는 LLM 추론 시 KV Cache를 3~4bit으로 실시간 압축하여 메모리를 최대 5~6배 절약하는 벡터 양자화 알고리즘이다. Google Research가 개발했으며, ICLR 2026에서 발표되었다.
1.2 해결하려는 문제
LLM 추론에서 가장 큰 메모리 소모원은 모델 가중치가 아니다. KV Cache다.
1
2
3
4
5
70B 모델, 128K context 기준:
  모델 가중치 (Q4_K_M): ~40GB
  KV Cache (FP16):       ~27.3GB  ← 가중치의 68%에 달하는 크기

  → context가 길어질수록 KV Cache가 가중치를 넘어선다
기존의 양자화 기법들(GPTQ, AWQ 등)은 모델 가중치를 줄이는 데 집중했다. 하지만 long context 시대에서 진짜 병목은 토큰이 생성될 때마다 계속 쌓이는 KV Cache다.
TurboQuant는 이 KV Cache를 FP16(16bit)에서 3~4bit으로 압축한다. 핵심은:
1
2
3
4
기존 양자화 (GPTQ, AWQ): 모델 가중치 압축 → 오프라인, 사전 처리
TurboQuant: KV Cache 압축 → 온라인, 실시간 처리

→ 두 기법은 서로 다른 메모리 영역을 최적화하므로 동시 적용 가능
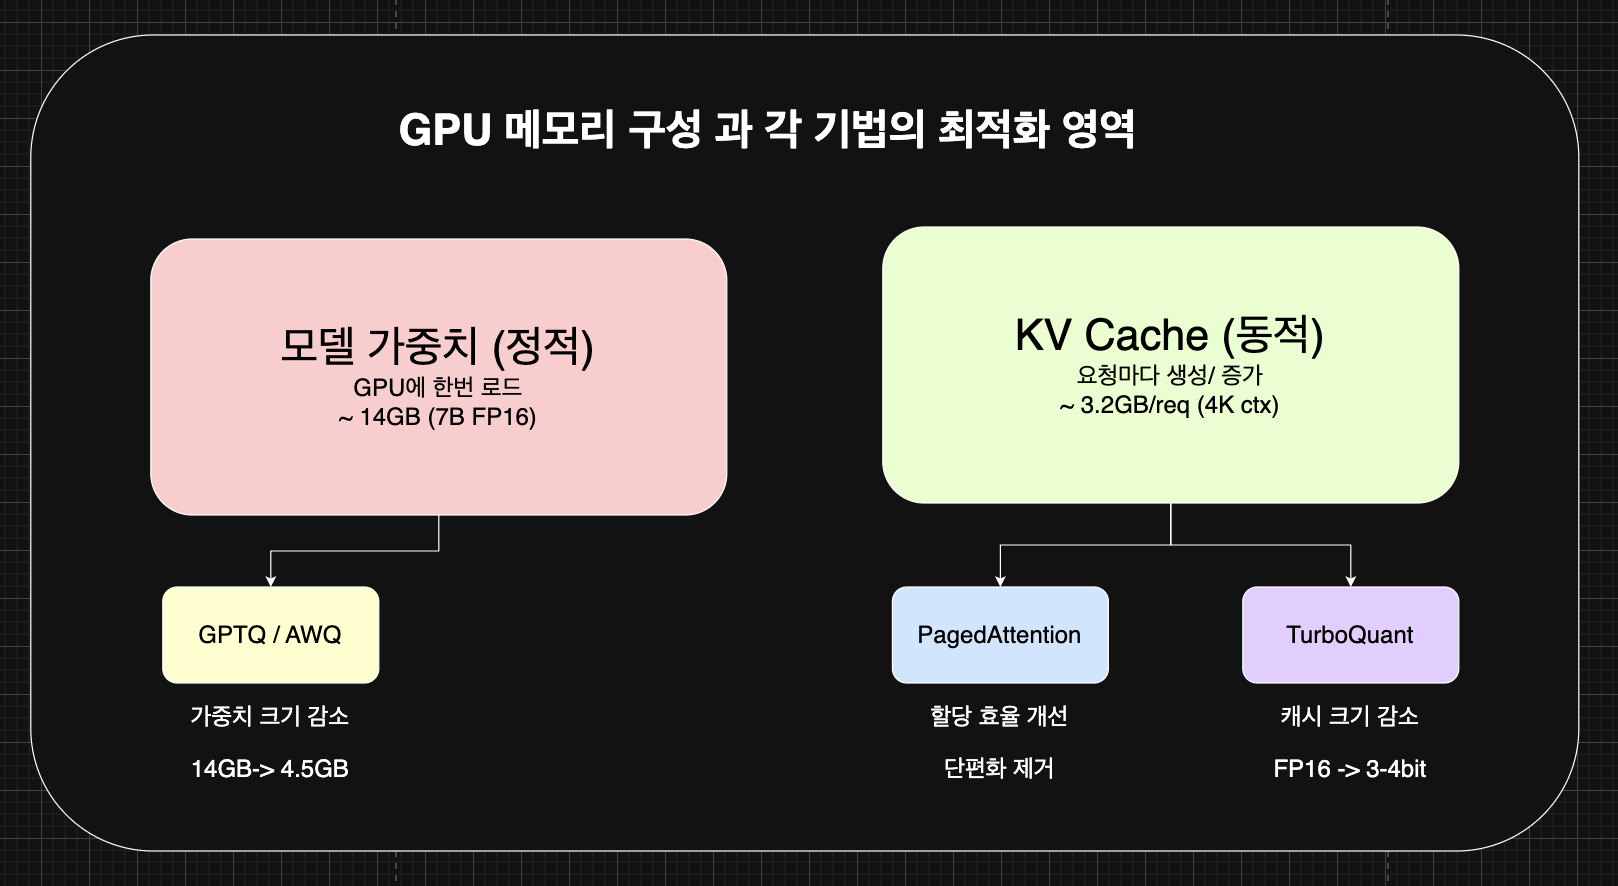 ▲ GPU 메모리 구성: AWQ는 모델 가중치를, TurboQuant는 KV Cache를 각각 최적화한다
1.3 그래서 뭐가 달라지는가
1
2
3
4
5
Before TurboQuant:
  Llama-3.1-8B @ 128K context → KV Cache만 16GB → A40 48GB에서 동시 2세션이 한계

After TurboQuant (3-bit):
  같은 조건 → KV Cache ~2.7GB → 동시 10세션 이상 가능
2. KV Cache란 무엇인가, 왜 문제가 되는가
TurboQuant가 왜 필요한지를 이해하려면, Transformer의 추론 과정에서 KV Cache가 어떤 역할을 하는지부터 알아야 한다.
2.1 Transformer 추론 파이프라인
사용자가 “한국에서 태어난 동물의 종류는 무엇입니까”라고 입력하면, LLM은 다음 과정을 거친다.
1
2
3
4
5
6
① 토크나이저: 텍스트 → 토큰 ID
   [한국, 에서, 태어, 난, 동물, 의, 종류, 는, 무엇, 입니까]

② 임베딩 + Positional Encoding: 각 토큰을 고차원 벡터로 변환
   "한국" → [0.12, -0.45, 0.78, ...] (768차원)
   → 결과: [10 × 768] 행렬
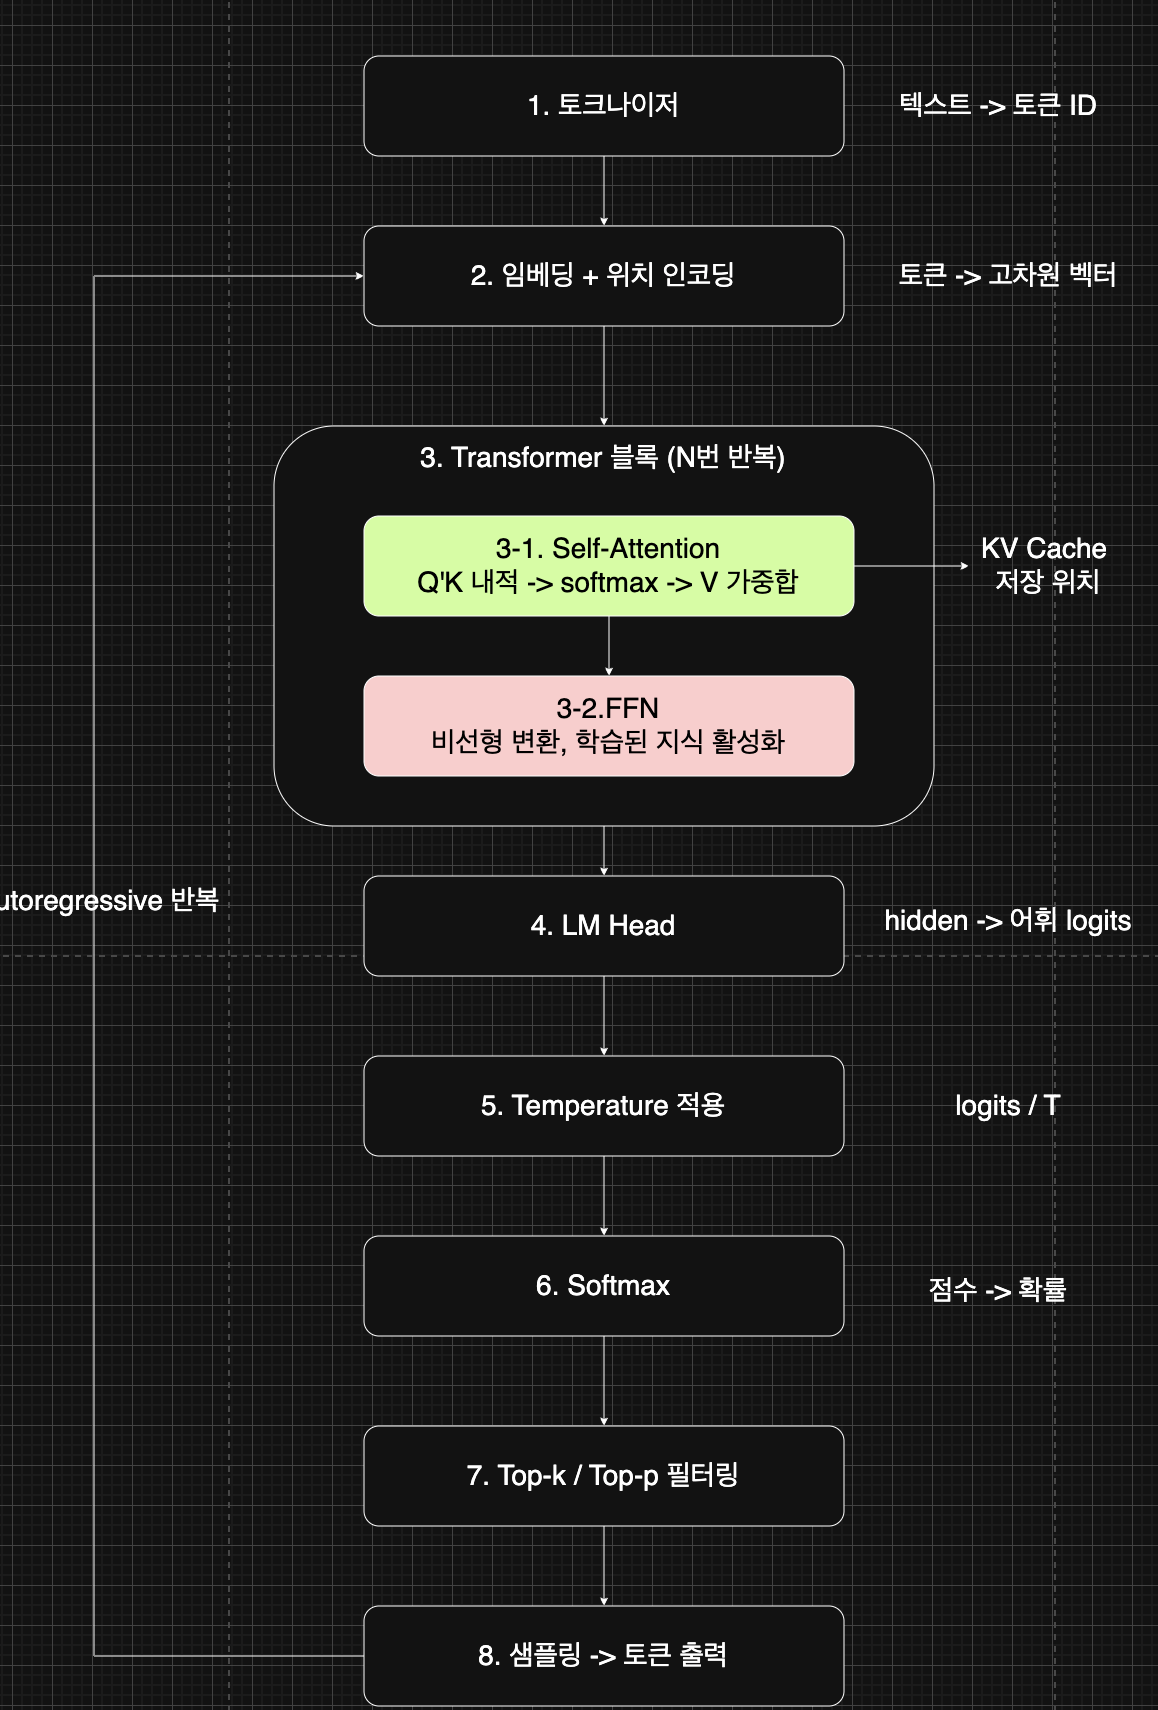 ▲ Transformer 추론 파이프라인: 토크나이저 → 임베딩 → Transformer 블록(N번) → LM Head → 샘플링 → Autoregressive 반복
2.2 Self-Attention: Q, K, V가 만들어지는 곳
Transformer 블록의 핵심인 Self-Attention에서 각 토큰의 임베딩으로부터 Q(Query), K(Key), V(Value)를 생성한다.
1
2
3
4
5
각 토큰의 임베딩에서 Q, K, V를 생성:
  "한국"   → Q₁, K₁, V₁
  "에서"   → Q₂, K₂, V₂
  ...
  "입니까" → Q₁₀, K₁₀, V₁₀
그런 다음 Attention Score를 계산한다. “입니까”의 Q₁₀이 모든 토큰의 K와 내적(inner product)을 수행한다.
1
2
3
4
5
6
7
8
9
Q₁₀ · K₁("한국")  = 0.8   ← 높은 관련도
Q₁₀ · K₅("동물")  = 0.9   ← 가장 높은 관련도
Q₁₀ · K₆("의")    = 0.1   ← 낮은 관련도
...

→ softmax 적용 → 가중치로 V를 가중합
= 0.15·V₁ + 0.05·V₂ + ... + 0.22·V₅ + ...

결과: "입니까" 위치의 새로운 벡터에 "동물", "한국" 정보가 강하게 반영
이 과정이 Multi-Head로 여러 “관점”에서 동시에 수행되고, FFN(Feed-Forward Network)에서 비선형 변환을 거쳐 학습된 지식(“한국 + 동물 + 태어난 → 호랑이”)이 활성화된다.
2.3 Autoregressive 생성과 KV Cache의 탄생
LLM은 토큰을 하나씩 생성한다(Autoregressive). “호랑이”를 생성한 후, 다음 토큰을 만들려면 이전 모든 토큰의 Attention을 다시 계산해야 한다.
1
2
3
1회차: "한국에서...입니까" → "호랑이" 생성
2회차: "한국에서...입니까 호랑이" → "는" 생성  ← 11개 토큰 전체 다시 계산?
3회차: "...호랑이는" → "한국" 생성              ← 12개 전체 다시 계산?
매번 전체를 다시 계산하면 O(n²) 연산이 필요하다. 여기서 KV Cache가 등장한다. 이전 토큰들의 K, V 값을 메모리에 저장해두고 재사용하면, 새 토큰의 Q만 계산해서 기존 K, V와 내적하면 된다.
1
2
3
4
5
6
KV Cache가 없으면:
  매 토큰 생성 시 모든 이전 토큰의 K, V를 재계산 → O(n²)

KV Cache가 있으면:
  이전 토큰의 K, V는 캐시에서 가져옴 → O(n) 으로 감소
  새 토큰의 K, V만 계산해서 캐시에 추가
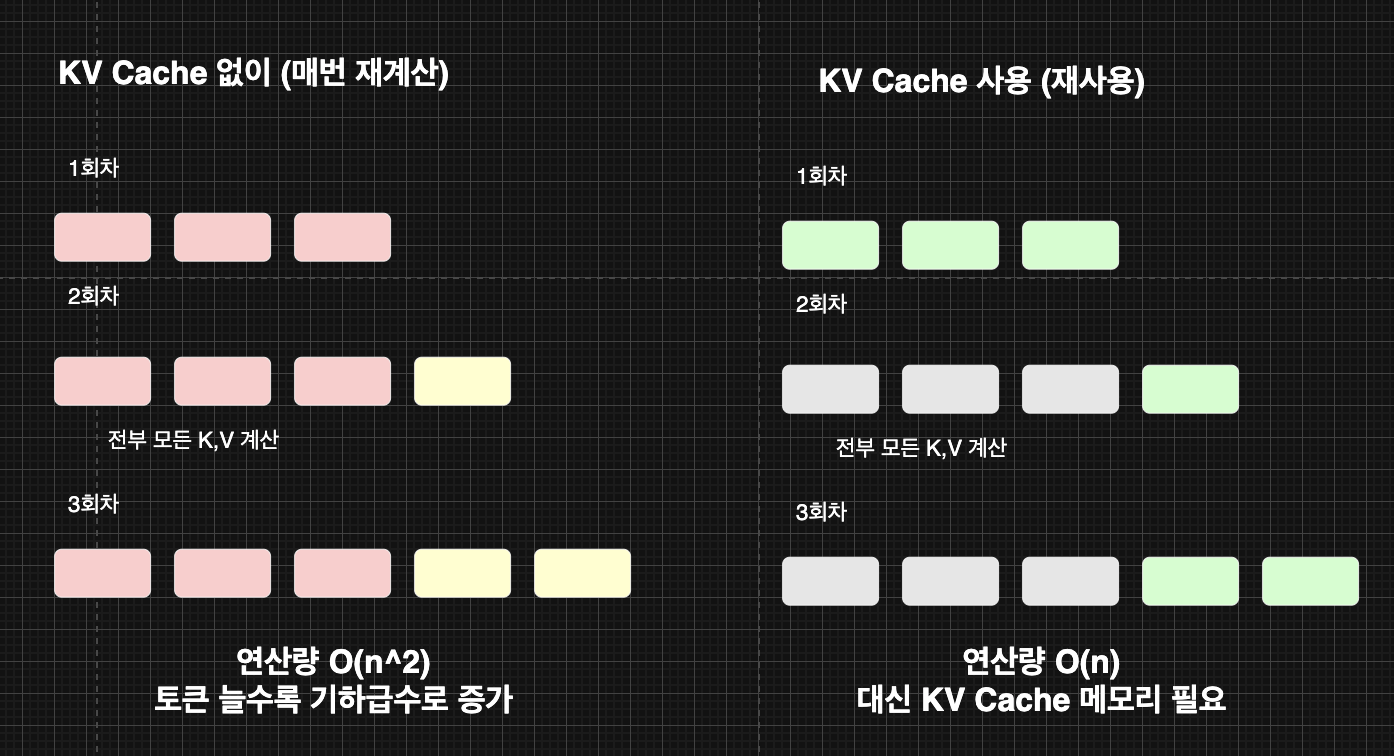 ▲ KV Cache 비교: 없으면 매 토큰마다 전체 재계산(O(n²)), 있으면 이전 K/V를 재사용(O(n))
2.4 KV Cache가 문제가 되는 이유
KV Cache 덕분에 추론이 빨라졌지만, 대가가 있다. 메모리를 엄청나게 먹는다.
1
2
3
4
5
6
7
KV Cache 크기 = 2 × layers × kv_heads × head_dim × seq_len × dtype_bytes

Qwen2.5-7B 기준 (GQA: 4 kv heads, seq_len=4096, FP16):
  2 × 28 × 4 × 128 × 4096 × 2bytes ≈ 224MB (요청 1건)

Llama-3.1-8B 기준 (GQA: 8 kv heads, seq_len=128K, FP16):
  2 × 32 × 8 × 128 × 131,072 × 2bytes ≈ 16GB (요청 1건!)
동시 사용자가 늘거나 context가 길어지면 KV Cache가 모델 가중치보다 더 큰 메모리를 차지한다. 이전 글에서 vLLM의 num_requests_waiting이 올라가고 Preemption이 발생했던 것도 바로 이 KV Cache 메모리 부족 때문이었다.
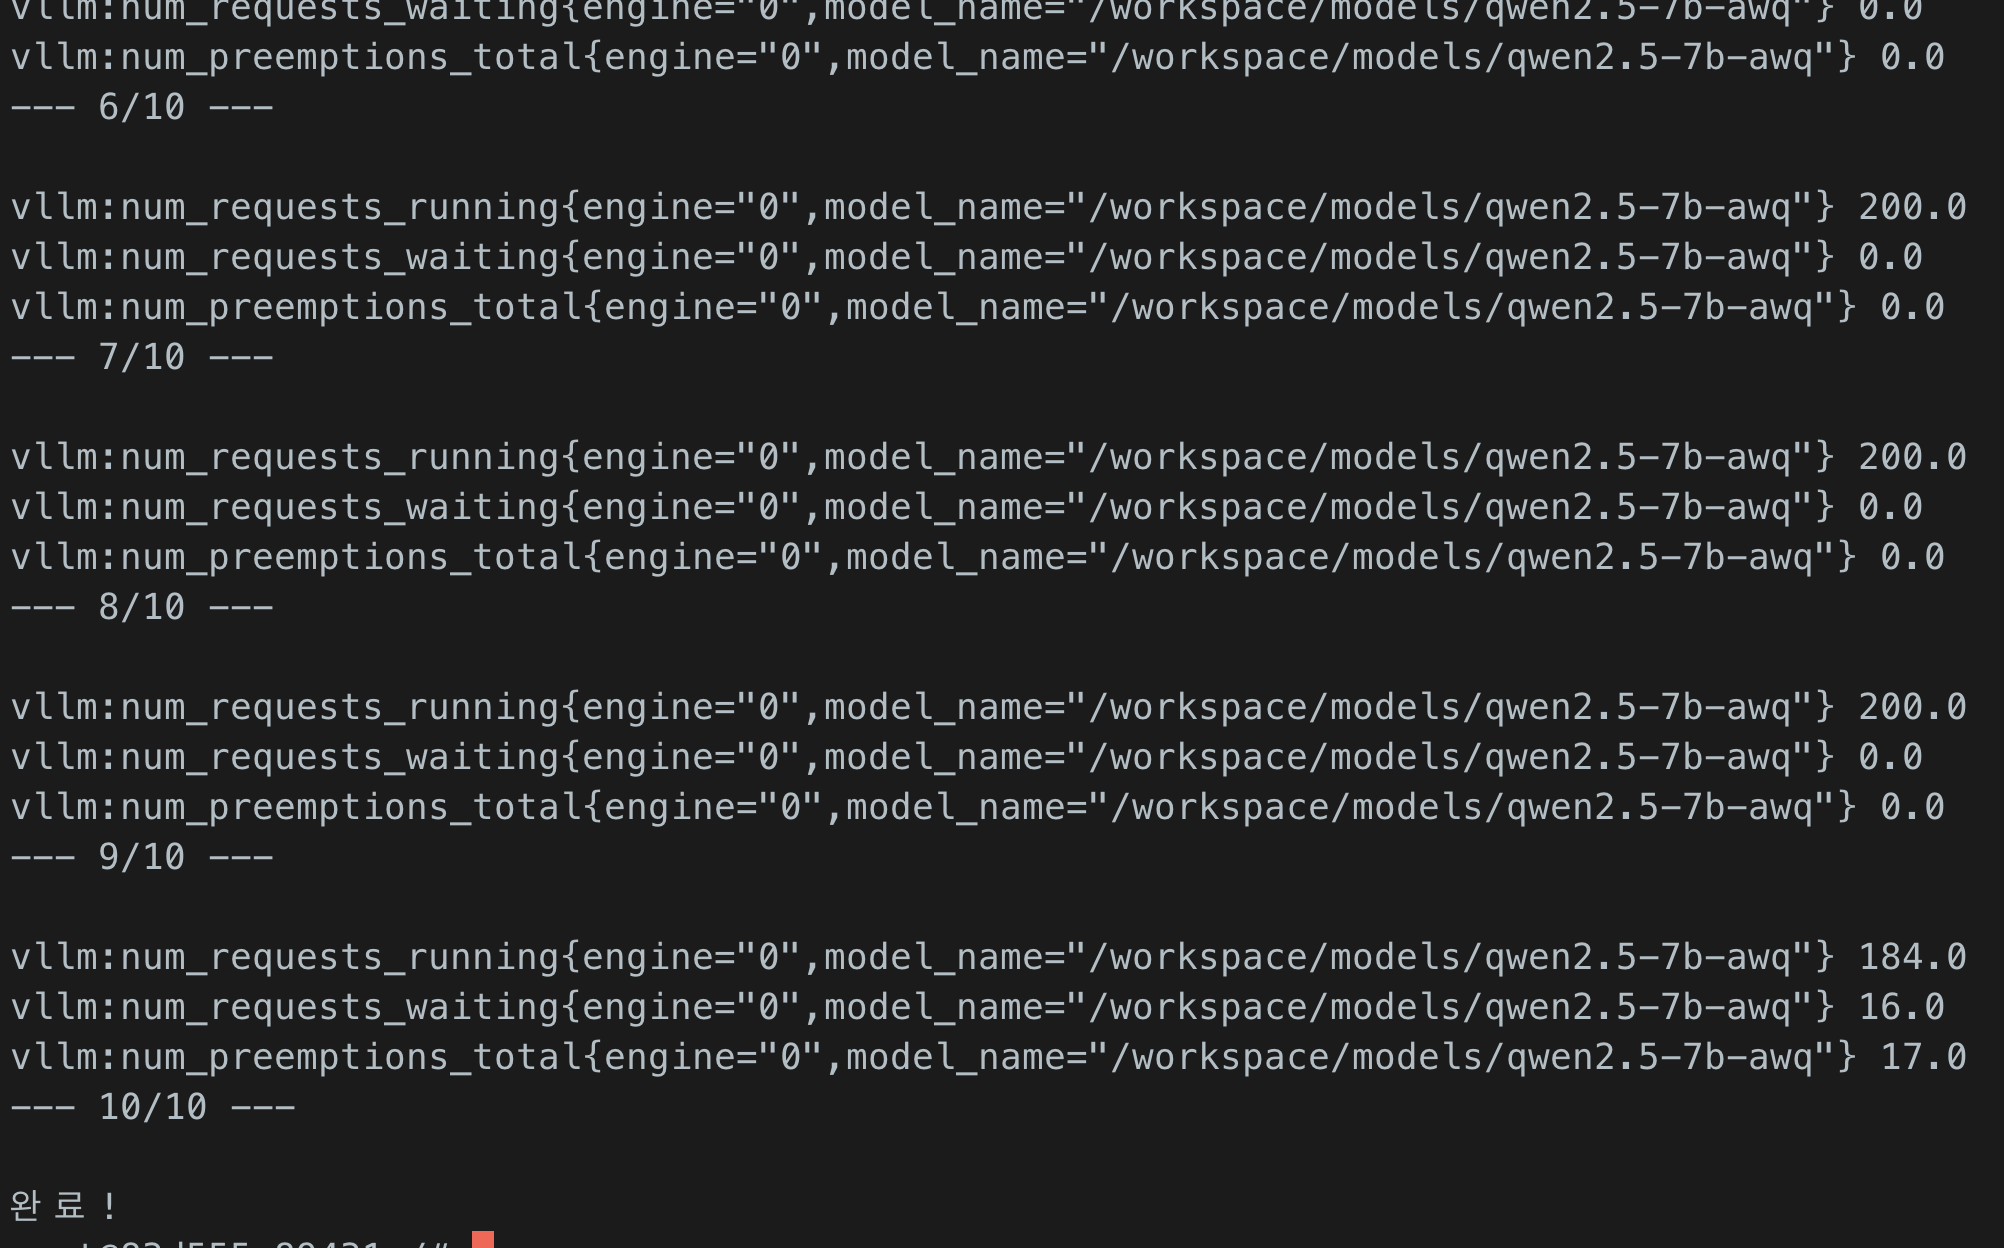 ▲ KV Cache 부족으로 num_requests_waiting=16, num_preemptions=17이 발생한 vLLM 메트릭
2.5 오해 주의: “사용자 1명 = 모델 1개”가 아니다
여기서 흔히 하는 오해가 있다. “KV Cache가 요청마다 필요하면, 사용자마다 모델도 따로 띄워야 하는 건가?” — 아니다.
모델 가중치는 GPU에 1개만 로드되고 모든 요청이 공유한다. KV Cache만 활성 요청(세션)마다 독립적으로 생성된다.
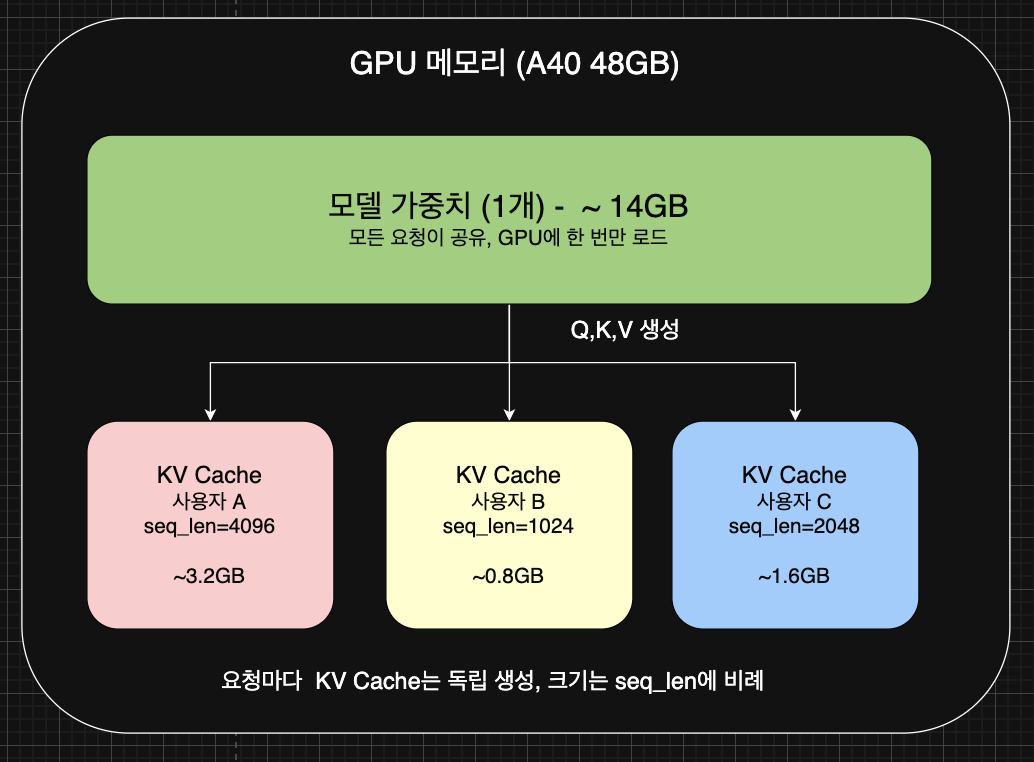 ▲ 모델 가중치는 1개를 공유하고, KV Cache만 활성 요청마다 독립적으로 생성된다
정확히는 “사용자” 단위가 아니라 “활성 요청/시퀀스” 단위로 KV Cache가 생긴다. 한 사용자가 탭 3개로 동시에 질문하면 KV Cache도 3개고, 사용자 100명이어도 동시에 추론 중인 요청이 10개면 KV Cache는 10개다.
그리고 크기도 요청마다 다르다 — 짧은 질문(“안녕”)은 KV Cache가 수 MB이고, 128K context 대화는 수 GB다. seq_len이 요청마다 다르기 때문이다.
1
2
3
KV Cache 크기 = 2 × layers × heads × head_dim × seq_len × dtype_bytes
                                                 ^^^^^^^^
                                                 이 값이 요청마다 다름!
또한 같은 system prompt를 사용하는 요청들은 prefix 부분의 KV Cache를 공유할 수 있다 (vLLM의 Automatic Prefix Caching).
1
2
3
4
5
Prefix Caching 예시:
  사용자 A: "너는 도움이 되는 AI 비서야. [사용자 질문 A]"
  사용자 B: "너는 도움이 되는 AI 비서야. [사용자 질문 B]"
  → "너는 도움이 되는 AI 비서야" 부분의 KV Cache는 물리 블록을 공유
  → 각 사용자의 고유 질문 부분만 별도 KV Cache 할당
출처: vLLM PagedAttention 공식 문서 — “The core idea of PagedAttention is to partition the KV cache of each request into KV Blocks.” docs.vllm.ai/en/latest/design/paged_attention
이것이 KV Cache 메모리 문제의 본질이다. 모델은 1개지만, 동시 요청이 늘어날수록 KV Cache가 선형적으로 증가한다. 이전 글에서 num_requests_waiting이 올라가고 Preemption이 발생했던 것도 바로 이 구조 때문이다.
3. 기존 해결 방향들: PagedAttention, AWQ, 그리고 한계
KV Cache 메모리 문제를 해결하려는 시도는 이전부터 있었다. 각 접근의 핵심과 한계를 정리한다.
3.1 PagedAttention (vLLM) — 할당 효율 개선
이전 글에서 다뤘듯이, PagedAttention은 KV Cache를 OS의 가상 메모리처럼 페이지 단위로 동적 할당한다.
1
2
3
4
5
기존: max_seq_len 전체를 미리 연속 할당 → 내부 단편화 60~70%
PagedAttention: 필요한 만큼만 블록 할당 → 단편화 제거

효과: 동일 GPU에서 동시 요청 2~4배 증가
한계: KV Cache "자체 크기"는 그대로 FP16
3.2 AWQ (Weight Quantization) — 가중치 압축
이전 글에서 벤치마크한 결과:
1
2
3
4
5
6
A40 48GB, Qwen2.5-7B 단일 요청:
  FP16: TTFT 57ms, TPS 35.4
  AWQ:  TTFT 99ms, TPS 15.2  ← 오히려 느려짐(GPU 아키텍처 따라 다름 A40의 경우 dequantization이 별도의 GPU 커널로 실행)

이유: VRAM 충분한 환경에서 dequantization 오버헤드가 더 큼
핵심: AWQ는 모델 가중치를 줄이지, KV Cache는 건드리지 않음
3.3 기존 KV Cache 양자화 — 스칼라 방식의 한계
TurboQuant 이전에도 KV Cache를 직접 압축하려는 시도가 있었다.
1
2
3
4
5
6
7
8
9
10
11
12
KIVI (2024):
  - KV Cache를 채널별 min-max scaling으로 INT4/INT2 양자화
  - 문제: 블록당 scale/zero-point 상수를 FP16으로 저장 → 1~2bit 오버헤드
  - 결과: 실질 압축률이 이론값보다 낮음

KVQuant (2024):
  - per-channel 양자화 + outlier 분리 처리
  - 문제: calibration 데이터 필요, 모델마다 튜닝 필요

SmoothQuant (2023):
  - activation의 outlier를 weight 쪽으로 이동 → 양자화 용이하게
  - 문제: weight와 activation 동시 양자화에 초점, KV Cache 전용이 아님
이들의 공통 한계는 스칼라 양자화(각 값을 독립적으로 양자화)를 사용한다는 점이다. 스칼라 양자화는 정보 이론적 한계 대비 지수적으로 비효율적이다.
1
2
3
4
5
6
스칼라 양자화 왜곡: ~ 2^(-b)     (b = bit-width)
벡터 양자화 왜곡:   ~ 2^(-2b)    ← 지수가 2배!

예시 (3-bit):
  스칼라: 2^(-3)  = 0.125
  벡터:   2^(-6)  = 0.0156  ← 8배 더 적은 왜곡
참고: KIVI — arXiv:2402.02750, KVQuant — arXiv:2401.18079, SmoothQuant — arXiv:2211.10438
3.4 정리: 각 접근이 최적화하는 영역
▲ 정리: PagedAttention은 할당 효율, AWQ는 가중치 크기, TurboQuant는 KV Cache 크기를 최적화한다
4. TurboQuant 핵심 해결 방식 3가지
논문: Zandieh et al., “TurboQuant: Online Vector Quantization with Near-optimal Distortion Rate” (ICLR 2026) arXiv:2504.19874
TurboQuant의 핵심은 3단계 파이프라인으로 구성된다. 각 단계를 쉽게 풀어서 설명한다.
4.1 핵심 1: 랜덤 회전 (Random Rotation) — 데이터를 “정리정돈”
비유: 옷장에 옷이 한쪽으로 몰려 있으면 정리가 어렵다. 옷을 골고루 펼쳐놓으면 같은 공간에 더 효율적으로 정리할 수 있다.
실제 LLM의 KV 벡터는 에너지가 특정 채널에 집중되어 있다. 어떤 좌표는 값이 수백이고, 어떤 좌표는 거의 0이다. 이런 불균일한 분포에 균일 양자화를 적용하면 효율이 크게 떨어진다.
TurboQuant는 KV 벡터에 랜덤 직교 행렬 R을 곱해서 에너지를 모든 좌표에 균등하게 분산시킨다.
1
2
3
4
5
6
7
8
9
10
11
회전 전: [178.5, 0.003, -392.1, 0.01, ...]  ← 에너지 편중
회전 후: [0.088, -0.091, 0.085, -0.087, ...]  ← 에너지 균등

수학적으로:
  x̃ = R · (x / ‖x‖)

회전 후 각 좌표는 Beta 분포를 따름 (고차원에서 가우시안에 근접)

실측 (Qwen 모델, scos-lab 구현체):
  회전 전 kurtosis: 900.4   ← 극단적으로 불균일
  회전 후 kurtosis: 2.9     ← 가우시안(3.0)에 거의 일치
핵심 포인트: 이 랜덤 회전은 data-oblivious — 어떤 모델이든, 어떤 데이터든 상관없이 같은 회전 행렬을 사용할 수 있다. calibration이 필요 없다는 뜻이다.
4.2 핵심 2: Lloyd-Max 최적 양자화기 — 수학적으로 최적인 “그물”
회전 후 모든 좌표가 동일한 Beta 분포를 따르므로, 이 분포에 대한 수학적으로 최적인 양자화 레벨(codebook)을 사전 계산할 수 있다.
비유: 낚시할 때 그물코의 크기를 물고기 분포에 맞춰 조절하면, 같은 크기의 그물로도 더 많은 물고기를 잡을 수 있다. Lloyd-Max는 “가장 효율적인 그물코 배치”를 수학적으로 구하는 알고리즘이다.
1
2
3
4
5
6
7
8
9
10
Lloyd-Max 양자화기 (1982, k-means의 1차원 버전):
  입력: 확률 분포 p(x), 양자화 레벨 수 2^b
  출력: 최적 경계값 {t_i}와 대표값 {c_i}

  예시 (3-bit, 2³=8개 레벨):
    경계값: [-0.142, -0.098, -0.054, -0.018, 0.018, 0.054, 0.098]
    대표값: [-0.168, -0.119, -0.075, -0.036, 0.036, 0.075, 0.119, 0.168]

  양자화: 입력값 0.065 → 경계값 비교 → 6번째 구간 → 대표값 0.075로 매핑
  역양자화: 인덱스 6 → 대표값 0.075 복원
이 codebook은 한 번만 계산하면 영구 사용 가능하다. 차원(d=128/256)과 bit-width(2/3/4)별로 미리 계산해두고, 런타임에는 단순 lookup만 수행한다.
1
2
3
4
5
6
기존 방식 (KIVI 등):
  블록마다 scale, zero-point를 FP16으로 저장 → 1~2bit 오버헤드

TurboQuant:
  사전 계산된 codebook 사용 → 오버헤드 0
  → 같은 3-bit라도 실질 압축률이 더 높음
4.3 핵심 3: QJL (Quantized JL) — 1-bit 오차 보정
Attention의 핵심 연산은 Q와 K의 내적(inner product)이다. MSE만 최소화하는 양자화기는 내적 추정에 편향(bias)을 만든다.
1
2
3
4
문제:
  MSE-optimal 양자화 후: E[⟨y, Q⁻¹(Q(x))⟩] ≠ ⟨y, x⟩  (biased!)
  → 양자화된 벡터가 원점 쪽으로 수축하는 경향 (attractor to origin)
  → 1-bit에서는 내적의 기대값이 실제의 2/π(≈0.64)배로 줄어듦
TurboQuant는 이 편향을 QJL(Quantized Johnson-Lindenstrauss)로 보정한다.
1
2
3
Stage 1: Lloyd-Max 양자화 → 잔차(residual) r = x - Q⁻¹(Q(x))
Stage 2: 잔차 r에 QJL 적용 → 랜덤 프로젝션 후 부호(sign)만 저장 → 1-bit
최종:    Q⁻¹(Q(x)) + QJL⁻¹(QJL(r)) → unbiased inner product 복원
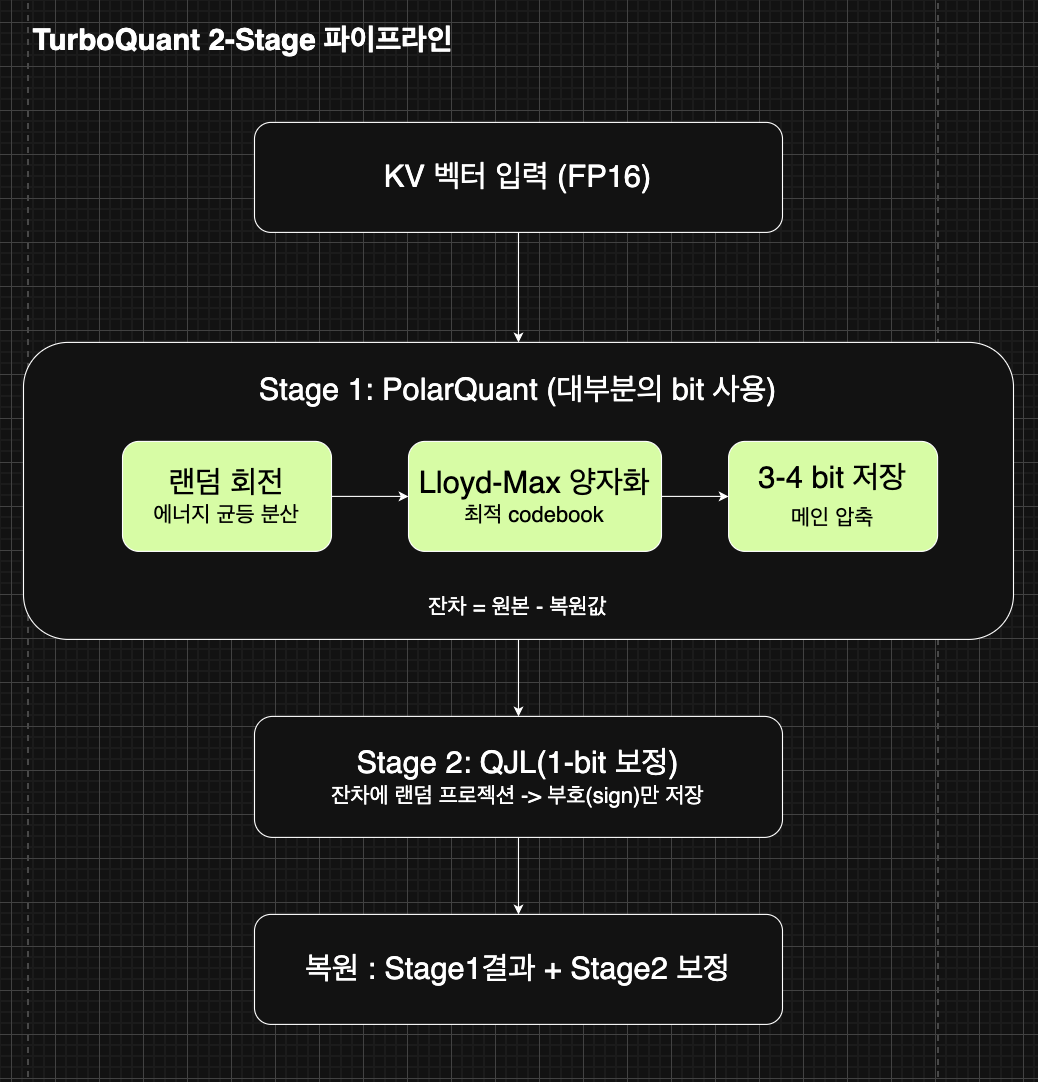 ▲ TurboQuant 파이프라인: 입력 벡터 → 랜덤 회전 → Lloyd-Max 양자화(Stage 1) → 잔차 → QJL 1-bit(Stage 2) → 복원
⚠️ 실전 발견: QJL은 Attention에서 역효과
논문의 QJL(Stage 2)은 이론적으로 완벽하다. 하지만 실제 LLM attention에서는 역효과를 낸다는 것이 6개 이상의 독립 구현체 팀에 의해 확인되었다.
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
원인:
  QJL → raw inner product에서 unbiased ✓
  하지만 Attention은 softmax를 통과:
    softmax(Q·K^T / √d) = exp(score_i) / Σexp(score_j)

  softmax는 비선형 → 분산(variance)을 지수적으로 증폭
  QJL: 낮은 bias + 높은 variance → softmax 후 폭발
  MSE-only: 약간의 bias + 낮은 variance → softmax 후 안정적

실측 (tonbistudio/turboquant-pytorch):
  QJL 적용(V2):    0/27 generation tests passed ❌
  QJL 제거(V3):    18/18 generation tests passed ✅

실측 (scos-lab/turboquant):
  QJL inner product error: +300%
  MSE-only inner product error: +7.6%
결론: KV Cache 양자화에서는 MSE-only(Stage 1만)가 실전에서 우세하다. QJL은 Vector Search(softmax 없음)에서는 유효하지만, attention의 softmax 비선형성을 고려하지 못했다.
4.4 정보 이론적 의미: 얼마나 최적에 가까운가
TurboQuant 논문의 가장 강력한 기여는 어떤 양자화기도 넘을 수 없는 정보 이론적 하한을 증명하고, TurboQuant가 이 하한의 ~2.7배 이내에 도달한다는 것이다.
1
2
3
4
5
Shannon 하한:      D*_mse ≥ (‖x‖² / d) · 2^(-2b)
TurboQuant 달성:   D_mse ≤ C · (‖x‖² / d) · 2^(-2b)   (C ≈ 2.7)
기존 스칼라 양자화: D_mse ~ (‖x‖² / d) · 2^(-b)

→ 스칼라 대비 "지수적" 개선: 2^(-b) vs 2^(-2b)
4.5 추가 실전 발견: K/V Norm 비대칭
커뮤니티 구현체들이 발견한 또 하나의 중요한 사실: Key와 Value의 norm이 수십~수백배 차이난다.
1
2
3
4
5
6
7
8
9
Qwen 모델 실측 (scos-lab):
  Key norm:   172 ~ 778
  Value norm: 2 ~ 4
  → 양자화 오차 ∝ norm² 이므로 Key가 ~37,000배 더 민감!

권장 전략:
  K/V ratio < 10x   → 3-bit 균일 (GPT-2 계열)
  K/V ratio 10~60x  → 비대칭 할당: Key 4bit, Value 2bit
  K/V ratio > 100x  → mixed precision 필수
5. 벤치마크: RunPod A40에서 KV Cache 양자화 실측
5.1 실험 환경
| 항목 | 스펙 |
|---|---|
| GPU | NVIDIA A40 48GB |
| CUDA | 12.8 |
| 모델 | meta-llama/Llama-3.1-8B-Instruct (논문과 동일) |
| 구현체 | hackimov/turboquant-kv (커뮤니티) |
| Python | 3.10 |
| PyTorch | 2.x + Triton |
⚠️ 주의: TurboQuant는 아직 Google 공식 코드가 공개되지 않았다. 아래 벤치마크는 커뮨니티 구현체를 사용한 것이며, 공식 구현과 성능이 다를 수 있다. 참고 : 테스트 환경은 논문에서 테스트한 모델인 meta-llama/Llama-3.1-8B-Instruct을 사용하였다.
5.2 환경 설정
1
2
3
4
5
6
7
# RunPod A40 환경 기준
pip install torch transformers accelerate scipy

# TurboQuant 커뮤니티 구현체 설치
git clone https://github.com/hackimov/turboquant-kv.git
cd turboquant-kv
pip install -e ".[triton]"
5.3 실험 1: 랜덤 회전의 Gaussianization 효과 검증
TurboQuant의 핵심 가정은 “랜덤 회전 후 좌표가 가우시안 분포를 따른다”는 것이다. Llama-3.1-8B의 실제 KV 벡터로 검증한다.
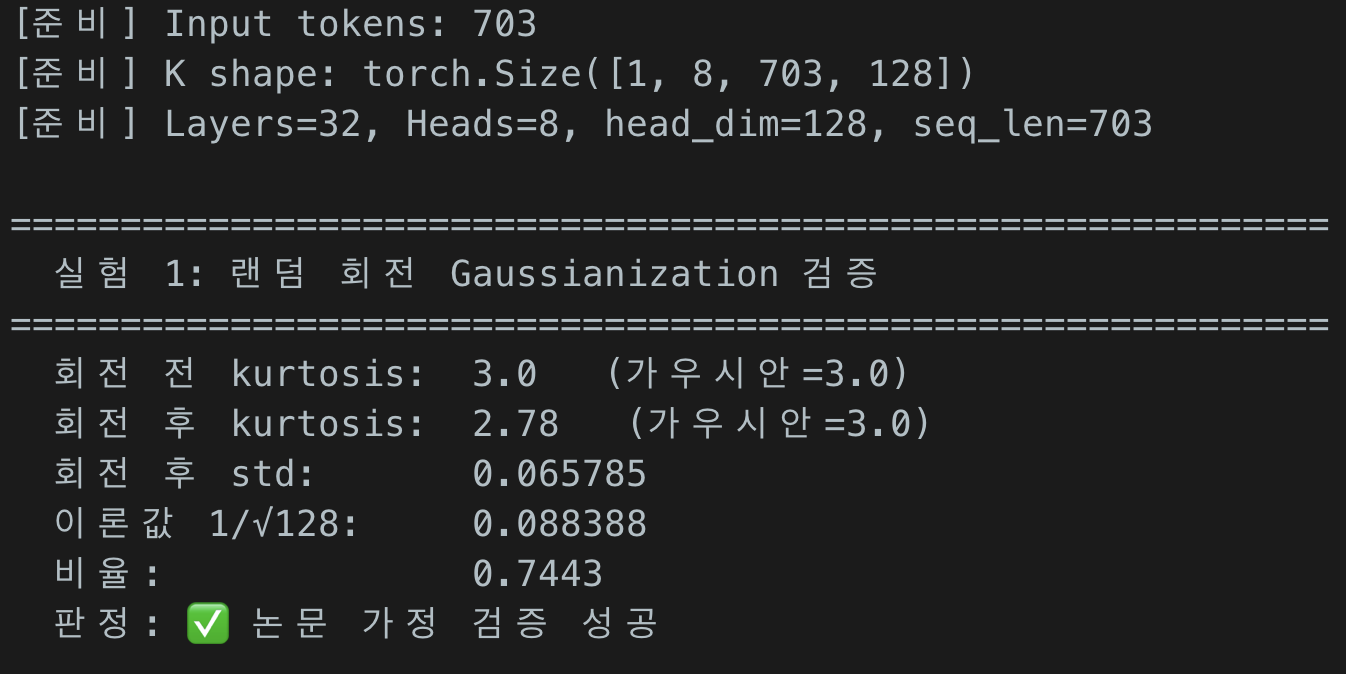 ▲ 실험 1 결과: Llama-3.1-8B의 KV 벡터에 랜덤 회전 적용 전/후 kurtosis 비교
결과:
| 메트릭 | 회전 전 | 회전 후 | 이론값 |
|---|---|---|---|
| Kurtosis | 3.0 | 2.78 | 3.0 (가우시안) |
| Std | - | 0.0658 | 0.0884 (1/√128) |
| Std 비율 | - | 0.7443 | 1.0 |
Llama-3.1-8B는 회전 전부터 kurtosis가 이미 3.0(가우시안) 이다. 이전에 커뮤니티에서 보고된 Qwen 모델의 kurtosis(~900)과는 완전히 다른 양상이다.
1
2
Qwen2.5-7B:     회전 전 kurtosis = ~900  → 회전 후 = ~2.9  (극적 변화)
Llama-3.1-8B:   회전 전 kurtosis = 3.0   → 회전 후 = 2.78  (이미 가우시안)
이것은 모델 아키텍처에 따라 KV 벡터의 분포 특성이 크게 다르다는 것을 보여준다. Llama 계열은 이미 에너지가 균등하게 분산되어 있어서 랜덤 회전의 효과가 크지 않지만, Qwen처럼 outlier가 심한 모델에서는 랜덤 회전이 필수적이다.
5.4 실험 2: K/V Norm 비대칭 분석
논문이 직접 다루지 않았지만 커뮤니티에서 발견된 중요한 특성 — Key와 Value의 norm 차이를 레이어별로 측정한다.
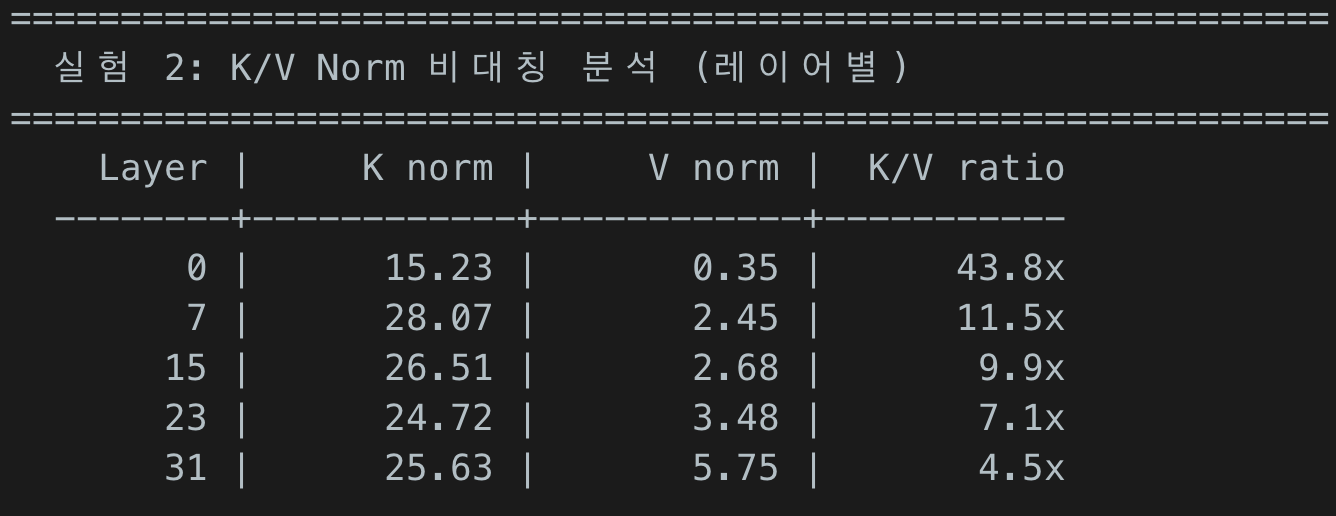 ▲ 실험 2 결과: 레이어별 Key/Value norm 측정. Layer 0에서 K/V ratio가 43.8배에 달한다
결과:
| Layer | K norm | V norm | K/V ratio |
|---|---|---|---|
| 0 | 15.23 | 0.35 | 43.8x |
| 7 | 28.07 | 2.45 | 11.5x |
| 15 | 26.51 | 2.68 | 9.9x |
| 23 | 24.72 | 3.48 | 7.1x |
| 31 | 25.63 | 5.75 | 4.5x |
Layer 0에서 K/V ratio가 43.8배에 달한다. 양자화 오차는 norm²에 비례하므로, Key가 Value보다 양자화에 훨씬 더 민감하다는 뜻이다. 이전 글(4.5절)에서 커뮤니티가 발견한 K/V 비대칭 문제를 실측으로 확인한 것이다.
1
2
3
4
양자화 오차 ∝ norm²
  Key (norm=15.23):  오차 ∝ 231.9
  Value (norm=0.35): 오차 ∝ 0.12
  → Key의 양자화 오차가 ~1,900배 더 큼!
이 결과는 K/V에 같은 bit-width를 할당하는 것이 비효율적임을 시사한다. Key에 더 많은 bit를 할당하는 비대칭 전략이 품질 보존에 효과적일 수 있다.
5.5 실험 3: Distortion 측정 (MSE, Cosine Similarity)
TurboQuant로 실제 KV 벡터를 양자화/복원했을 때의 왜곡을 전체 32개 레이어 평균으로 측정한다.
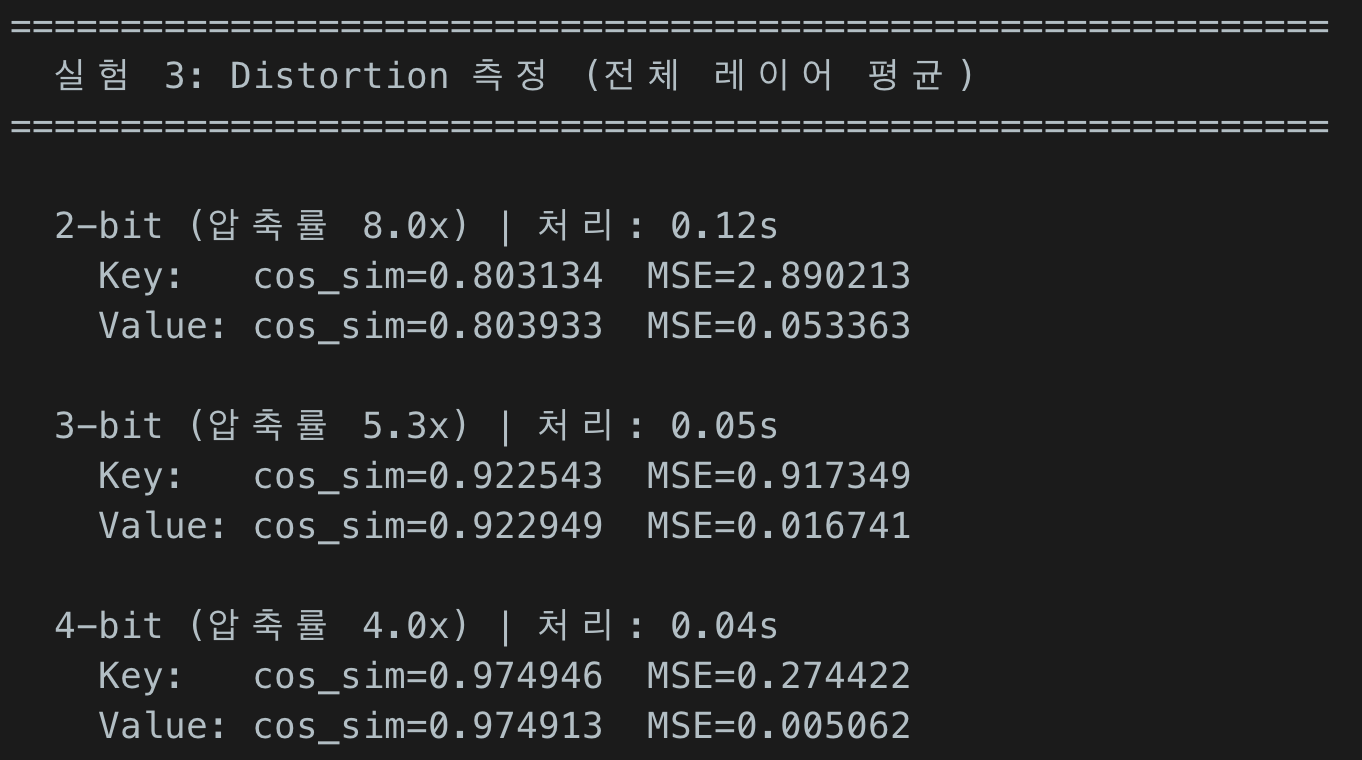 ▲ 실험 3 결과: bit-width별 MSE와 Cosine Similarity. 4-bit에서 cos_sim 0.975로 실용적 임계점
결과:
| bit-width | Key cos_sim | Value cos_sim | Key MSE | Value MSE | 압축률 |
|---|---|---|---|---|---|
| 4-bit | 0.9749 | 0.9749 | 0.274 | 0.005 | 4.0x |
| 3-bit | 0.9225 | 0.9229 | 0.917 | 0.017 | 5.3x |
| 2-bit | 0.8031 | 0.8039 | 2.890 | 0.053 | 8.0x |
주목할 점이 두 가지 있다. 첫째, Key와 Value의 cos_sim은 거의 동일하지만 MSE는 크게 다르다 (4-bit 기준 Key MSE 0.274 vs Value MSE 0.005 — 54배 차이). 이는 실험 2에서 확인한 K/V norm 비대칭이 양자화 오차에 직접 반영된 것이다.
둘째, cos_sim 기준으로 보면 4-bit(0.975)이 실용적 임계점이다. 3-bit(0.923)부터는 내적 계산의 정확도가 떨어지기 시작하며, 2-bit(0.803)은 attention score가 크게 왜곡될 수 있다.
1
2
3
논문의 주장:    3.5-bit에서 "absolute quality neutrality"
커뮤니티 실측:  4-bit cos_sim 0.975 → 실용적
               3-bit cos_sim 0.923 → 주의 필요
5.6 실험 4: NIAH Proxy (Attention Score Top-1 보존)
논문의 Needle-in-a-Haystack(4.2절) 방식을 참고한 프록시 테스트다. 랜덤 K 벡터에 “needle”을 주입한 후, TurboQuant 양자화/복원 후에도 attention score의 top-1 위치가 보존되는지를 확인한다.
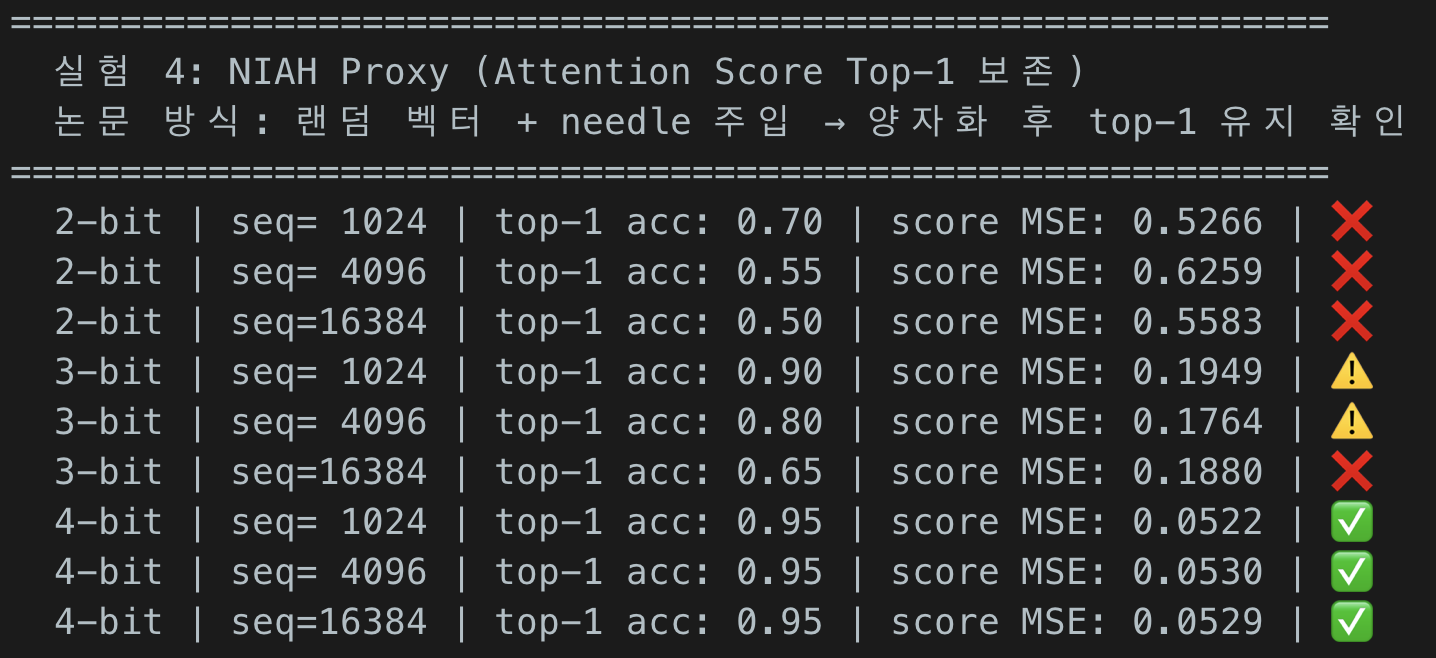 ▲ 실험 4 결과: Attention Score Top-1 보존율. 4-bit은 sequence 길이와 무관하게 0.95로 안정적
결과:
| bit-width | seq=1,024 | seq=4,096 | seq=16,384 |
|---|---|---|---|
| 4-bit | ✅ 0.95 | ✅ 0.95 | ✅ 0.95 |
| 3-bit | ⚠️ 0.90 | ⚠️ 0.80 | ❌ 0.65 |
| 2-bit | ❌ 0.70 | ❌ 0.55 | ❌ 0.50 |
4-bit은 sequence 길이와 무관하게 안정적(0.95) 이지만, 3-bit은 sequence가 길어질수록 정확도가 떨어진다 (1K: 0.90 → 16K: 0.65). 2-bit은 모든 조건에서 사실상 사용 불가다.
1
2
3
4
핵심 인사이트:
  4-bit → seq_len에 무관하게 안정적 → long context 서빙 가능
  3-bit → 짧은 context(1~4K)에서만 실용적 → long context에서는 위험
  2-bit → attention score 자체가 훼손 → 실전 사용 불가
이 결과는 논문의 “3.5-bit에서 quality neutrality” 주장과 커뮤니티 구현체 사이의 차이르 보여준다. 추후 Google 내부 구현에서는 outlier 처리, 비대칭 K/V 할당 등의 추가 최적화가 적용되었을 가능성이 높다. 이에따라 벤치마크를 다시 테스트 할 예정이다.
5.7 전체 벤치마크 결과 요약
| 실험 | 핵심 결과 |
|---|---|
| Gaussianization | Llama는 회전 전부터 kurtosis=3.0 (Qwen과 대조적) |
| K/V Norm 비대칭 | Layer 0에서 K/V ratio 43.8배 — Key가 양자화에 훨씬 민감 |
| Distortion (4-bit) | cos_sim 0.975, Key MSE가 Value MSE의 54배 |
| NIAH Proxy (4-bit) | seq 16K에서도 top-1 보존율 0.95 — long context 서빙 가능 |
6. 마무리 및 참고 링크
이전 글과의 연결
1
2
3
4
5
6
7
8
9
[이전 글] PagedAttention → KV Cache "할당 효율" 개선 (단편화 60~70% 감소)
[이전 글] AWQ           → 모델 "가중치 크기" 감소 (14GB → 4.5GB)
[이번 글] TurboQuant     → KV Cache "자체 크기" 감소 (3-bit으로 ~5x 압축)

세 기법은 상호보완적:
  AWQ로 가중치를 줄이고
  PagedAttention으로 KV Cache 할당을 효율화하고
  TurboQuant로 KV Cache 자체를 압축하면
  → 동일 GPU에서의 동시 처리량과 context 길이가 비약적으로 증가
핵심 정리
| 개념 | 기억할 포인트 |
|---|---|
| TurboQuant 본질 | 모델 가중치가 아닌 KV Cache를 실시간 양자화하는 기법 |
| 핵심 3단계 | ① 랜덤 회전 → ② Lloyd-Max 양자화 → ③ QJL 보정 (실전에서는 ①②만 사용) |
| 정보 이론 | 기존 스칼라 양자화 대비 지수적 개선 (2^-b → 2^-2b), Shannon 한계의 ~2.7배 |
| 실전 주의점 | QJL은 softmax 후 variance 폭발 → MSE-only 권장, K/V 비대칭 할당 필요 |
| 현재 상태 | Google 공식 코드 미공개, 커뮤니티 구현체 6개+, vLLM/llama.cpp 통합 진행 중 |
LLM 서빙 설계 원칙 (업데이트)
- GPU 메모리가 충분하면 FP16 가중치: 양자화는 메모리가 부족할 때만 (이전 글)
- Continuous Batching은 필수: Static 대비 throughput 6배 (이전 글)
- KV Cache 양자화는 long context의 열쇠: 3.5-bit이면 품질 손실 없이 ~5x 절약 (이번 글)
- K/V 비대칭 할당 고려: 모델별 K/V norm ratio 확인 필수 (이번 글)
- num_requests_waiting 모니터링: 이 값이 오토스케일링 트리거 (이전 글)
참고 자료
논문
- TurboQuant: Zandieh et al., arXiv:2504.19874 (ICLR 2026)
- TurboQuant 논문 HTML: arxiv.org/html/2504.19874v1
- PagedAttention: Kwon et al., “Efficient Memory Management for Large Language Model Serving with PagedAttention” (2023)
- QJL: Zandieh et al., “QJL: 1-Bit Quantized JL Transform for KV Cache Quantization with Zero Overhead” (2024)
해설 및 튜토리얼
- TurboQuant 딥다이브 (wikidocs) — 모델 크기별 권장 bit-width, 프로덕션 배포 전략
- TurboQuant vs Traditional Quantization (Medium) — 기존 양자화와의 차이, 오버헤드 제거 원리
- TurboQuant in Practice (SOTAAZ) — llama.cpp 빌드, HuggingFace 통합, 메모리 계산기
- Google Research Blog — Google 공식 해설
커뮤니티 구현체
- hackimov/turboquant-kv — PyTorch + Triton, HF 통합, fused attention
- scos-lab/turboquant — K/V 비대칭 분석, 49개 테스트
- tonbistudio/turboquant-pytorch — QJL 이슈 발견, V3 개선판
- TheTom/turboquant_plus — llama.cpp 통합, turbo2/3/4 타입
프레임워크 통합 진행 상황
이전 글